AI code review staat voor twee taken: een AI-tool die een codewijziging beoordeelt, en een mens die code beoordeelt die een AI-tool heeft geschreven. Dit artikel gaat over de tweede taak: een herhaalbare manier om AI-gegenereerde code in pull requests te reviewen, te bepalen wie elke wijziging goedkeurt en het bewijs te bewaren dat het samenvoegen rechtvaardigt. Het is geen vergelijking van AI code review-tools. U leest de twee betekenissen van AI code review, de redenen voor een menselijke goedkeurder, een reviewproces in vijf lagen, het bewijs dat elke pull request nodig heeft en wanneer u een wijziging escaleert.
TL;DR
AI code review betekent een AI-tool die code controleert, of een mens die code controleert die een AI schreef. AI-gegenereerde code heeft het tweede nodig als laatste goedkeuring: een review op basis van alleen de diff en de repository kan bedrijfsregels en datagrenzen missen die nooit zijn vastgelegd of aangeleverd.
- Twee betekenissen, één gat: een review door een AI-tool markeert bekende fout- en stijlpatronen in een diff; een review van AI-gegenereerde code bevestigt vóór het samenvoegen dat de wijziging veilig doet wat het bedrijf nodig heeft.
- Vier redenen voor een menselijke goedkeurder: AI-reviewers werken vaak met dezelfde beperkte context als de AI-auteur, nette code kan het verkeerde doen, AI-tools kunnen pakketten voorstellen die niet bestaan, en er wordt elke week meer code samengevoegd dan iemand leest.
- Een reviewproces in vijf lagen bestaat uit twee geautomatiseerde lagen (pipelinecontroles, een AI-reviewer) en drie menselijke lagen (bedrijfsregels, vertrouwensgrenzen en data, reviewdiepte naar blast radius), elk met een benoemde eigenaar en vastgelegd bewijs.
- Escaleer een pull request als de reviewer de bedrijfsregel niet kan bevestigen, een rechtencontrole niet kan reproduceren of het effect van een migratie op bestaande data niet kan uitleggen; houd de merge aan tot een gekwalificeerde reviewer het gat dicht.
Hoe u een AI-gebouwd product met echte gebruikers in productie brengt, leest u in de gids AI coding in productie. Dit artikel gaat één niveau dieper, naar de review van elke pull request.
Wat betekent AI code review: twee verschillende taken
AI code review is óf een review door een AI-tool, waarbij een taalmodel commentaar geeft op een pull request, óf een review van AI-gegenereerde code, waarbij een mens code controleert die een AI-tool schreef. De twee taken beantwoorden een andere vraag en hebben een andere grens. Een pull request is een voorgestelde wijziging die iemand goedkeurt voordat die wordt samengevoegd; een diff is de lijst met regels die veranderen.
| Betekenis | Wat het is | Vraag die het beantwoordt | Grens |
|---|---|---|---|
| Review door een AI-tool | Een reviewer op basis van een taalmodel geeft commentaar op pull requests of in de editor | Bevat deze wijziging bekende fout-, security- of stijlpatronen? | Werkt met de context die de tool krijgt: meestal de diff en de repository, zelden contracten, gebruikers of ongeschreven bedrijfsregels |
| Review van AI-gegenereerde code | Een mens keurt binnen een vast proces code goed die een AI-tool schreef | Doet deze wijziging veilig wat ons bedrijf nodig heeft, en ligt het bewijs vast? | Vraagt iemand die het bedrijf kent en code kan lezen, of een onafhankelijke reviewer |
De richtlijn van GitHub voor het reviewen van AI-gegenereerde code maakt dezelfde splitsing vanuit de ontwikkelaar: AI-reviewtools zijn één stap in een proces dat nog steeds een menselijke controle van context en bedoeling bevat. De algemene afweging tussen mensen en tools staat in de gids over manual en automated code review.
Waarom heeft AI-gegenereerde code een menselijke review nodig?
AI-gegenereerde code heeft een menselijke goedkeurder nodig omdat een AI-wijziging er af kan uitzien voordat die klopt, en een review op basis van alleen de diff en de repository dat verschil kan missen. Vier mechanismen verklaren dat gat.
De AI-reviewer deelt de blinde vlekken van de AI-auteur
Een AI-reviewer ziet wat hij krijgt: de diff, de repository en soms de prompthistorie. Worden de productspecificatie, de prijsregels of de rollenmatrix niet aangeleverd, dan kan de AI-reviewer de wijziging daar niet aan toetsen. Twee modellen die op vergelijkbare openbare code zijn getraind, accepteren bovendien vaak dezelfde patronen: een fout die voor het auteursmodel normaal oogde, kan ook voor het reviewmodel normaal ogen.
AI-reviewers vinden wel echte problemen in gegenereerde code, zeker als ze de productspecificatie en de relevante tests krijgen. Het risico zit in regels die nooit zijn opgeschreven of aangeleverd. Een menselijke goedkeurder bevestigt het verwachte gedrag met de producteigenaar, bekijkt gewijzigde tests en vraagt bewijs voor risicovolle onderdelen vóór het samenvoegen. Het onderzoeksbewijs over AI-tools die hun eigen output controleren, staat in de gids AI coding in productie.
Nette code die het verkeerde doet
Leesbare code en geslaagde tests bewijzen niet dat de software correct werkt. Neem een illustratief scenario: een planningsapp voor Nederlandse installatiebedrijven. Een AI-refactor slaat afspraaktijden op met een vaste UTC-offset van +02:00 in plaats van de tijdzone Europe/Amsterdam. Als Nederland op 25 oktober 2026 overgaat van zomertijd (CEST) naar wintertijd (CET), toont elke afspraak voor een datum na de omschakeling een uur te laat.
De testsuite blijft in dit scenario groen, omdat dezelfde AI-wijziging ook de verwachte testuitkomsten aanpaste aan het nieuwe gedrag. De les voor elke review van AI-gegenereerde code: review de tests net zo goed als de code, en markeer elke pull request die code en tests tegelijk wijzigt.
Pakketten en functies die niet bestaan
AI-codingtools stellen soms bibliotheken of functies voor die niet bestaan; dat heet package hallucination. In de testset van Spracklen et al. produceerden 16 codegenererende modellen 576.000 codevoorbeelden, en het gemiddelde aandeel verzonnen pakketten was minstens 5,2% bij commerciële modellen en 21,7% bij opensourcemodellen (“We Have a Package for You!”, USENIX Security 2025). Die percentages gelden voor de prompts en modellen uit het onderzoek, niet voor elk product.
Aanvallers kunnen verzonnen pakketnamen registreren en er kwaadaardige code onder publiceren; die tactiek heet slopsquatting. Een afhankelijkheid is een externe bibliotheek waarop het product draait. Voor elke nieuwe afhankelijkheid in AI-gegenereerde code ligt een besluit vast: het pakket bestaat, wordt onderhouden en is het pakket dat het team bedoelde.
Meer code dan iemand leest
AI-codingtools verhogen de hoeveelheid code per ontwikkelaar, en review wordt de stap die teams overslaan. Het DORA-onderzoek van 2024 vond dat 25% meer AI-gebruik samenging met 7,2% minder stabiliteit in softwarelevering en 1,5% minder leveringssnelheid (DORA, Impact of Generative AI in Software Development). DORA presenteert dit als samenhang, niet als bewezen oorzaak.
De drempel: wordt er elke week meer code samengevoegd dan één persoon kan lezen, bepaal dan welke delen van het product een mens moet lezen. Laag 5 van het reviewproces legt die regel vast.
Hoe reviewt u AI-gegenereerde code: vijf lagen
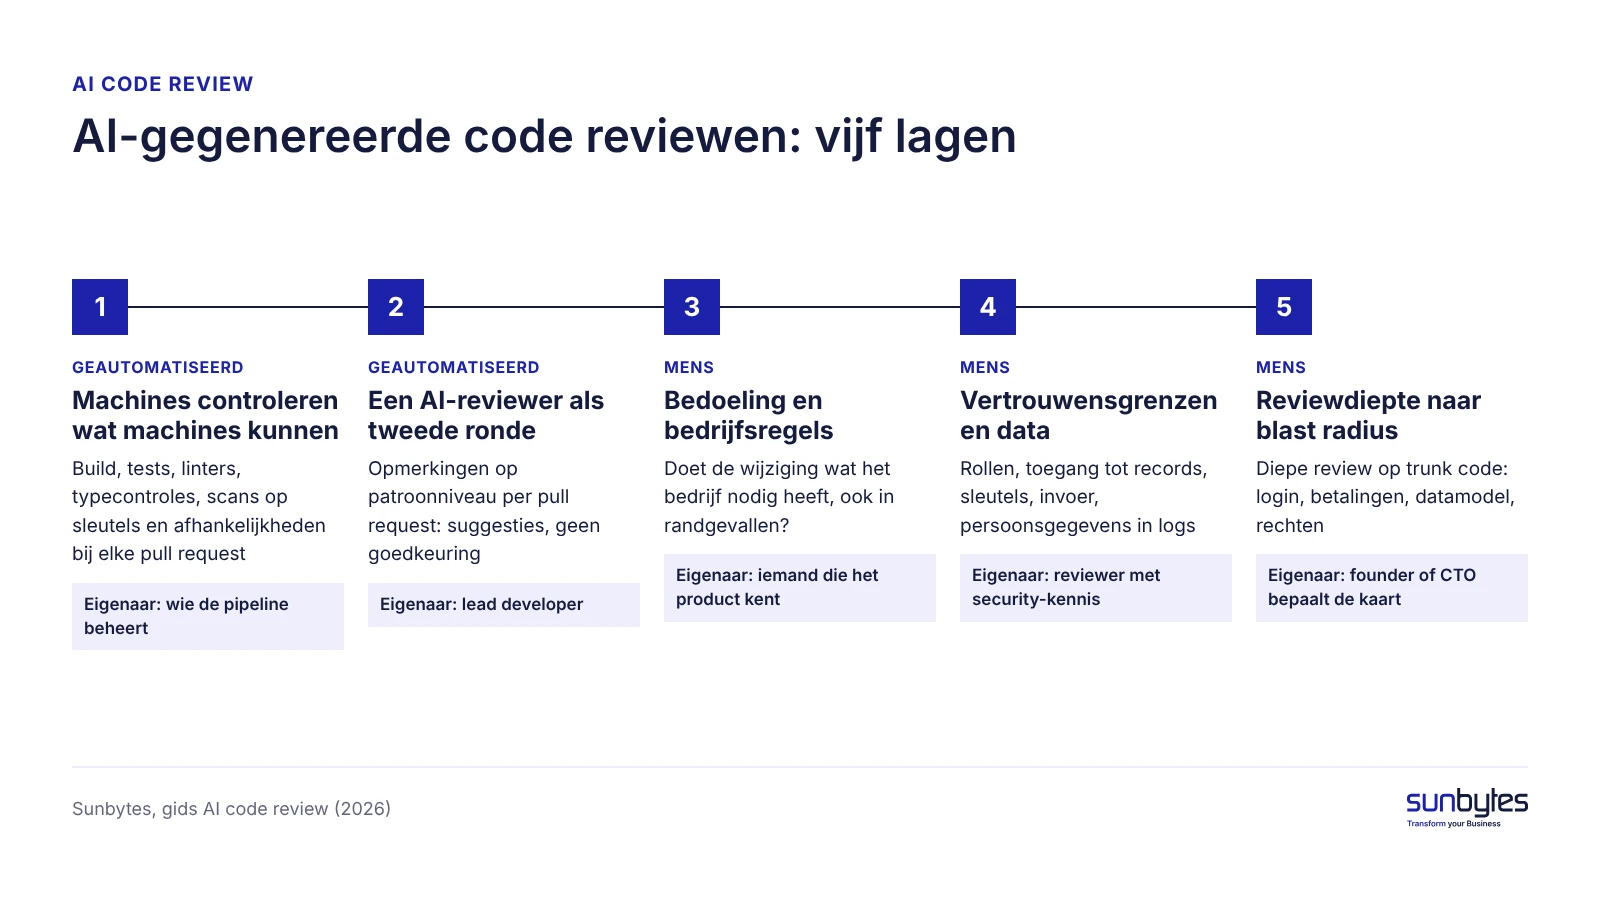
Review AI-gegenereerde code in vijf lagen: twee geautomatiseerd en drie menselijk. Elke laag heeft een eigenaar, één concrete controle en een stuk bewijs dat in de pull request komt. De vijf lagen zijn een redactioneel model van Sunbytes, geen NIST-framework; het model sluit aan bij practice PW.7 van het NIST Secure Software Development Framework (SP 800-218, v1.1), dat vraagt om het reviewen of analyseren van leesbare code om kwetsbaarheden te vinden en securityeisen te controleren.
Laag 1: laat machines controleren wat machines kunnen
Laag 1 voert bij elke pull request geautomatiseerde controles uit in de CI-pipeline: de code compileert, bestaande tests slagen, linters en typecontroles draaien, en scans zoeken naar gelekte geheime sleutels en kwetsbare bibliotheken. Een linter markeert stijl en veelvoorkomende fouten; een geheime sleutel is een wachtwoord, token of API-sleutel die nooit in de code hoort. Eigenaar is wie de pipeline beheert; het bewijs is het pipelineresultaat bij de pull request.
De controle die bij AI-gegenereerde code vaak wordt vergeten: zijn tests verwijderd, overgeslagen of herschreven zodat ze slagen? Ook de richtlijn van GitHub noemt die valkuil.
Laag 2: zet een AI-reviewer in als tweede ronde
Laag 2 zet een AI-reviewer op elke pull request om patroonfouten snel te vinden: dubbele logica, onveilige functies, ontbrekende foutafhandeling, inconsistente namen. Geef de AI-reviewer de regels van het team en waar mogelijk de specificatie van de wijziging; behandel de opmerkingen als suggesties, niet als goedkeuring. Eigenaar is de lead developer, die vastlegt welke opmerkingen zijn opgevolgd. Gratis en opensource reviewtools kunnen deze laag draaien; de tool weegt minder zwaar dan wie de opmerkingen opvolgt. Hoe scanners en menselijke securityreview het werk in een pipeline verdelen, leest u in secure code review vs SAST.
Laag 3: een mens toetst bedoeling en bedrijfsregels
In laag 3 bevestigt een mens dat de wijziging doet wat het bedrijf nodig heeft, en niet alleen wat de prompt vroeg. De reviewer legt de oorspronkelijke prompt of ticket naast de wijziging en controleert de randgevallen die AI-gegenereerde code vaak mist: lege lijsten, ontbrekende waarden, twee gebruikers die tegelijk iets doen, tijdzones en zomertijd, valuta en btw-afronding, terugbetalingen en annuleringen.
Eigenaar van laag 3 is iemand die de productregels kent; het bewijs is diens bevestiging van het verwachte gedrag, bij voorkeur met concrete voorbeelden. Een reviewer die de prijsregel niet kan benoemen, keurt een wijziging daarvan niet goed.
Laag 4: een mens toetst vertrouwensgrenzen en data
In laag 4 controleert een mens elke vertrouwensgrens in de wijziging. Een vertrouwensgrens is elk punt waar de code bepaalt wie iemand is en wat die persoon mag. De reviewer controleert authenticatie en rollen, wie welke records mag lezen of wijzigen, geheime sleutels in code of front-end, invoer van gebruikers en derden, en het loggen van persoonsgegevens. Broken Access Control staat als A01 in de OWASP Top 10:2025; het bewijs voor laag 4 is een rechtencontrole die per betrokken rol is geverifieerd.
Artikel 32 van de AVG (GDPR) eist beveiligingsmaatregelen die passen bij het risico voor persoonsgegevens. De AVG schrijft geen menselijke code review voor; een beleid waarbij code die persoonsgegevens verwerkt vóór het samenvoegen door een mens wordt gereviewd, is ons advies om die risicogebaseerde plicht in te vullen. De veelvoorkomende risico’s in AI-gebouwde apps staan in vibe coding beveiligingsrisico’s.
Laag 5: bepaal de reviewdiepte naar blast radius
Laag 5 bepaalt welke wijzigingen een diepe menselijke review krijgen. Blast radius betekent de impact als het misgaat: wat breekt er, en voor wie. Trunk code is de code waar veel functies van afhangen: login, betalingen, het datamodel, rechten en integraties. Leaf code zit aan de rand, zoals teksten en lay-out. Eigenaar is de founder of CTO, die de kaart van trunk-onderdelen één keer vastlegt en bijwerkt als het product verandert.
Hoe diep reviewt u: inzet naar blast radius
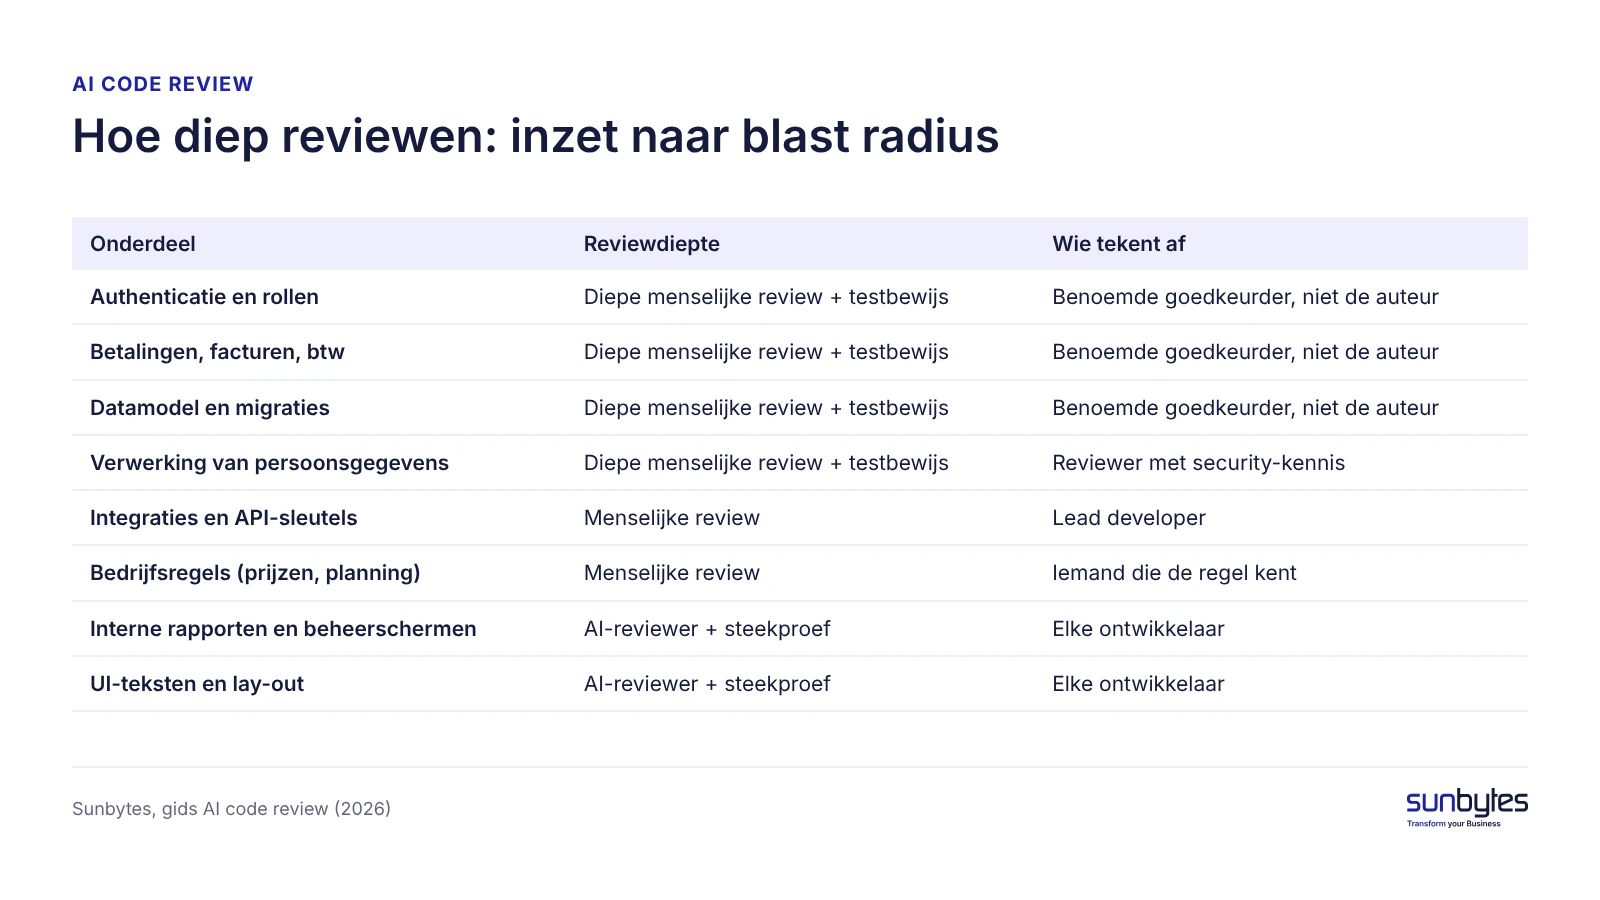
De reviewdiepte voor AI-gegenereerde code hangt af van wat er breekt als de wijziging fout is, niet van het aantal regels. Een wijziging van drie regels in een rechtencontrole kan klantdata blootleggen, terwijl een grote lay-outwijziging dat meestal niet kan, tenzij die ook exports, rechten of dataquery’s raakt. Tabel 2 geeft de diepte per onderdeel van het product.
| Onderdeel | Voorbeeld | Reviewdiepte | Wie tekent af |
|---|---|---|---|
| Authenticatie en rollen | Login, wachtwoordherstel, beheerdersrol | Diepe menselijke review + testbewijs | Benoemde goedkeurder, niet de auteur |
| Betalingen, facturen, btw | Afrekenen, terugbetalingen, btw-afronding | Diepe menselijke review + testbewijs | Benoemde goedkeurder, niet de auteur |
| Datamodel en migraties | Nieuwe kolom, ander datumformaat | Diepe menselijke review + testbewijs | Benoemde goedkeurder, niet de auteur |
| Verwerking van persoonsgegevens | Exports, logs, profielpagina’s | Diepe menselijke review + testbewijs | Reviewer met security-kennis |
| Integraties en API-sleutels | Betaalprovider, CRM-koppeling | Menselijke review | Lead developer |
| Bedrijfsregels | Prijzen, planning, voorwaarden | Menselijke review | Iemand die de regel kent |
| Interne rapporten en beheerschermen | Wekelijks verkooprapport zonder exports | AI-reviewer + steekproef | Elke ontwikkelaar |
| UI-teksten en lay-out | Knopteksten, witruimte | AI-reviewer + steekproef | Elke ontwikkelaar |
Een reviewrecord maakt de diepte zichtbaar. Het voorbeeld hieronder toont het minimale record voor een AI-gegenereerde betaalwijziging.
| Veld | Invulling |
|---|---|
| Doel van de wijziging | Btw-afronding bij terugbetalingen voor Nederlandse klanten corrigeren |
| AI-gegenereerde scope | src/billing/refunds en de refund-tests |
| Geautomatiseerd bewijs | Build, unittests en dependency-scan geslaagd |
| Bewijs bedrijfsregel | Finance-eigenaar keurde de verwachte afrondingsvoorbeelden goed |
| Regressiebewijs | Eerdere terugbetalingsvoorbeelden slagen nog; gewijzigde testverwachtingen zijn gereviewd |
| Securitybewijs | Rechten voor terugbetalingen geverifieerd voor klant- en beheerdersrol |
| Besluit | Pas goedkeuren na akkoord van een reviewer die niet de auteur is; anders merge aanhouden |
Heeft een trunk-onderdeel geen benoemde persoon die het kan reviewen, dan is dat gat de reden om een externe reviewer in te schakelen.
Wat een founder kan controleren zonder code te lezen
Een founder kan bij elke pull request vier dingen controleren zonder één regel code te lezen. Elke controle is zichtbaar op de pull-requestpagina van elk gangbaar codeplatform.
- De pull request beschrijft in één zin wat de wijziging moet doen en linkt naar het ticket of de prompt.
- Een wijziging in een trunk-onderdeel noemt een menselijke goedkeurder die niet de auteur is.
- Testbewijs is bijgevoegd, en testbestanden die in dezelfde pull request zijn gewijzigd, zijn gemarkeerd.
- Nieuwe externe pakketten staan vermeld met een besluit: goedgekeurd of afgewezen.
Ontbreekt bij een risicovolle pull request een goedkeurder die niet de auteur is, relevant testbewijs of een besluit over een nieuwe afhankelijkheid, voeg die dan niet samen. Wijs een eigenaar aan en dicht het gat in die pull request; wacht niet tot het proces herhaaldelijk faalt.
Laag 1 en 2 draaien vanzelf. Laag 3 tot 5 vragen om iemand die weet waar hij op moet letten.
Kan niemand in uw team AI-gegenereerde code goedkeuren aan de hand van uw bedrijfsregels en de grenzen van de klantgegevens? Dan kan een onafhankelijke reviewer dat deel overnemen. Een AI-built product review staat los van wie de code herstelt, met bevindingen in begrijpelijke taal en een geprioriteerd actieplan.
Welk bewijs heeft een pull request nodig vóór het samenvoegen?
Een AI-gegenereerde pull request is klaar om samen te voegen als het bewijs voor elke relevante vraag vastligt, niet als een tool of een mens zegt dat het er goed uitziet. AI-reviewers en scanners leveren een deel van dat bewijs; de rest vraagt iemand met toegang tot de regels, de rollen en de testresultaten. Tabel 4 geeft het bewijs per vraag.
| Vraag | Bewijs van een AI-reviewer of scanner | Bewijs dat een mens toevoegt |
|---|---|---|
| Zijn stijl en structuur consistent? | Linter en opmerkingen van de AI-reviewer | Geen, tenzij opmerkingen worden betwist |
| Lijkt de code op een bekend kwetsbaar patroon? | Scannerbevindingen en AI-opmerkingen | Besluit per bevinding: herstellen, accepteren of vals positief |
| Brengt een nieuwe afhankelijkheid risico mee? | Uitvoer van de dependency-scan | Besluit per nieuw pakket: goedgekeurd of afgewezen |
| Volgt de functie de bedrijfsregel? | Kan afwijkingen markeren als de specificatie is aangeleverd | Bevestiging van de producteigenaar met concrete voorbeelden |
| Kan een klant bij de data van een andere klant? | Kan mogelijke toegangsproblemen markeren | Rollenmatrix en rechtentests per betrokken rol |
| Zijn tests afgezwakt zodat de wijziging slaagt? | Kan gewijzigde of verwijderde testbestanden markeren | Notitie van de reviewer waarom elke verwachting veranderde |
| Is dit de juiste bevinding om eerst op te lossen? | Ernstlabels | Prioriteitsbesluit van de eigenaar van de release |
Wij raden aan de AI-reviewer op elke pull request te houden, omdat die routinebevindingen weghaalt voordat een mens tijd aan de wijziging besteedt. De voorwaarde: op trunk code is de AI-reviewer nooit de enige goedkeuring.
Wanneer escaleert u een AI-gegenereerde pull request?
Een routinereview is niet genoeg als een wijziging een onderdeel raakt dat niemand in het team kan verifiëren. Houd de merge aan als de reviewer de geldende bedrijfsregel niet kan bevestigen, een rechtencontrole niet kan reproduceren of het effect van een migratie op bestaande data niet kan uitleggen. Wijs een gekwalificeerde reviewer aan, leg het ontbrekende bewijs vast en draai de relevante tests opnieuw vóór de goedkeuring.
Een ander besluit speelt wanneer u vertrouwen nodig hebt in het hele product: vóór de lancering, vóór de security-vragenlijst van een zakelijke klant, bij een due diligence, na een grote AI-herschrijving of bij een overdracht van het ontwikkelwerk. Dat is de scope van een onafhankelijke AI code audit, niet de goedkeuring van één pull request. Zakelijke inkopers in de EU vragen vaak naar veilig programmeren en securitytests, de onderwerpen van ISO/IEC 27001:2022 Annex A 8.28 en 8.29 (ISO/IEC 27001:2022).
Hoe Sunbytes AI-gegenereerde code reviewt
Een AI code review slaagt wanneer iemand de code goedkeurt aan de hand van hoe het bedrijf werkt, niet aan de hand van de prompt die de code opleverde. In laag 3 tot 5 heeft een AI-reviewer het minst om mee te vergelijken: bedrijfsregels, de grenzen van de klantgegevens en de delen van het product met de grootste impact als het misgaat.
Sunbytes zet een onafhankelijke reviewer op precies die vragen met een AI-built product review. De reviewer heeft de code niet geschreven of geprompt en wordt niet ingehuurd om te herstellen. Raken de bevindingen toegangsbeheer, geheime sleutels of AVG-bewijs, dan past de review de securitydiepte van laag 4 toe; de bevindingen komen in begrijpelijke taal met een geprioriteerd actieplan, zodat reviewer, bewijs en herstelwerk gescheiden blijven.
Sunbytes is een in Nederland opgerichte partner voor technologie, cybersecurity en personeelsoplossingen, met het hoofdkantoor in Utrecht en een delivery hub in Ho Chi Minh-stad. In meer dan 15 jaar heeft Sunbytes ruim 300 projecten opgeleverd voor klanten in 20 landen, binnen een ISO/IEC 27001-gecertificeerd managementsysteem voor informatiebeveiliging. Toegang tot uw code valt tijdens de review onder dat systeem, met governance vanuit Nederland.
Is laag 3 tot 5 vandaag bij iemand in uw team belegd? → Bespreek uw AI-gebouwde product met ons.