AI-codingtools kunnen technische schuld veroorzaken wanneer een team gegenereerde code sneller accepteert dan het die reviewt, test en documenteert, en die schuld ziet er zelden kapot uit. AI technical debt is code die in productie werkt, maar die niemand in het team kan uitleggen, veilig kan aanpassen of kan herleiden tot een bewuste keuze. Het risico groeit wanneer een product van een vibe coding-prototype naar betalende gebruikers gaat zonder onafhankelijke controle van de code, de dependencies en de kritieke gebruikersflows.
Dit artikel behandelt vier praktische typen AI technical debt, een raamwerk van vijf stappen, de KPI’s om te volgen en de signalen waarbij externe hulp loont. Voor het bredere beeld leest u de gids AI coding in productie.
TL;DR
AI technical debt is de toekomstige kostenpost van het aanpassen van code die een AI-tool sneller schreef dan uw team die kon begrijpen, testen of documenteren. Technische schuld is het extra werk dat u later betaalt voor een shortcut van nu, een metafoor uit het OOPSLA-ervaringsrapport van Ward Cunningham uit 1992. U beheert AI technical debt door de schuld in kaart te brengen, te rangschikken op bedrijfsrisico, reviewregels toe te voegen en haar in geplande sporen op te lossen.
- AI technical debt heeft vier praktische vormen: begripsschuld, verborgen afhankelijkheidsschuld en patroondivergentie in elke codebase waaraan AI meeschreef, plus modelveroudering in producten die tijdens gebruik een AI-model aanroepen.
- Een raamwerk van vijf stappen houdt de schuld beheersbaar: een inventaris van AI-schuld opbouwen, prioriteren op bedrijfsrisico, AI-specifieke review- en documentatieregels toevoegen, herstelsporen inrichten en een maandelijks reviewritme voor de schuldbacklog instellen.
- Vijf KPI’s laten zien of de schuld afneemt: reviewbelasting, onderhoudsfrictie, kennisconcentratie, blootstelling via dependencies en beveiliging, en leveringsimpact. Grijp in wanneer een KPI twee maanden achter elkaar de verkeerde kant op beweegt.
- Externe hulp is zinvol wanneer kritieke modules geen duidelijke eigenaar hebben, beveiligingsbewijs voor een klant- of leveranciersreview ontbreekt, of het herstelwerk meer is dan het team in twee kwartalen aankan.
Veroorzaakt AI technische schuld?
AI-codingtools veroorzaken technische schuld wanneer ze sneller code toevoegen dan een team die reviewt, test en documenteert. De Maintainability Gap-analyse 2026 van GitClear van 623 miljoen codewijzigingen laat zien dat het aandeel gekopieerde regels steeg van 9,4% van alle gewijzigde regels in 2022 naar 15,7% in de eerste helft van 2026. In dezelfde periode daalde verplaatste code, het duidelijkste signaal van refactoring, van 21% naar 3,8%. Er komt dus meer nieuwe code bij en er wordt minder bestaande code opgeschoond.
Technische schuld is de extra inspanning die een team later betaalt voor een eerdere shortcut, zoals tests overslaan of een functie kopiëren in plaats van hergebruiken. Refactoren is de structuur van code veranderen zonder het gedrag te veranderen, en het is de gebruikelijke manier om die schuld af te lossen. De klassieke oorzaken en typen staan in de gids voor het identificeren en beheren van technische schuld. AI-gegenereerde code voegt daar nieuwe oorzaken aan toe.
Hoe AI-gegenereerde code technische schuld laat oplopen
AI-gegenereerde code kan technische schuld laten oplopen wanneer de assistent de bestaande codebase als context gebruikt. Assistenten die de omliggende bestanden lezen, nemen vaak de patronen over die ze vinden, ook de inconsistente, zodat één shortcut het sjabloon kan worden voor de volgende bestanden. Gedupliceerde logica maakt bovendien elke fix duurder: een bug in gekopieerde code moet in elke kopie worden opgelost, en een gemiste kopie wordt een regressie, een bug die iets breekt dat eerder werkte.
Die opbouw vertraagt wanneer elke door AI geschreven wijziging dezelfde lat voor review, tests en documentatie haalt als handgeschreven code. Ze versnelt wanneer de hoeveelheid output stijgt en die lat blijft waar hij was.
Wat zijn de vier typen AI technical debt?
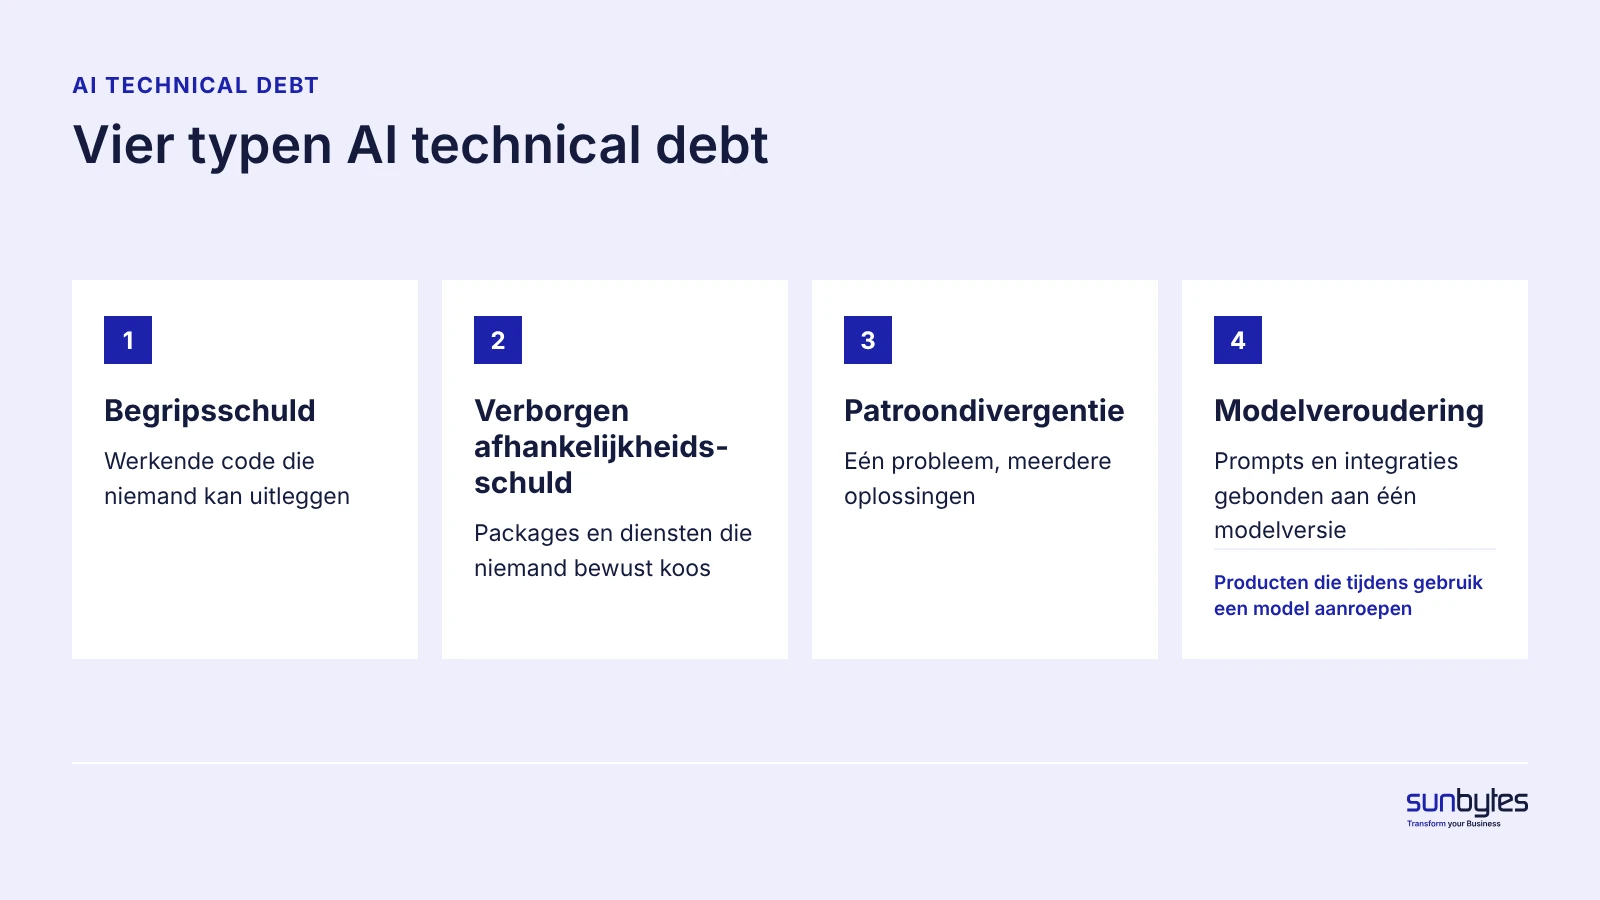
AI technical debt valt uiteen in vier praktische typen: begripsschuld, verborgen afhankelijkheidsschuld, patroondivergentie en modelveroudering. De eerste drie gelden voor elke codebase waaraan een AI-tool meeschreef; modelveroudering geldt alleen wanneer het product tijdens gebruik een AI-model aanroept. Elk type heeft een eigen vroeg signaal en een eigen eerste fix, zoals Tabel 1 laat zien.
Begripsschuld
Begripsschuld is code in productie die niemand in het huidige team kan uitleggen, zoals een betaalwebhook die om onbekende redenen drie keer opnieuw probeert. De kosten worden zichtbaar zodra die code moet veranderen. In de Stack Overflow Developer Survey 2025 noemde 66% van de respondenten AI-oplossingen die bijna kloppen een frustratie, terwijl 45% zei dat het debuggen van AI-gegenereerde code meer tijd kost. Het vroege signaal is een code review waarin het enige antwoord op “waarom werkt dit?” luidt: “de AI heeft het geschreven”.
Verborgen afhankelijkheidsschuld
Verborgen afhankelijkheidsschuld zijn de libraries, packages en diensten die een AI-tool toevoegde zonder dat iemand er bewust voor koos, zoals drie datumlibraries in één repository. Sommige voorgestelde packages bestaan niet eens: een studie naar package-hallucinaties (USENIX Security 2025) van 576.000 gegenereerde codevoorbeelden vond dat 5,2% van de packages die commerciële modellen aanbevalen verzonnen was, tegenover 21,7% bij opensourcemodellen. Aanvallers kunnen die verzonnen namen registreren, waardoor een ongecontroleerde installatie van een schuldpost een beveiligingsbevinding maakt.
Patroondivergentie
Patroondivergentie is hetzelfde probleem dat op meerdere manieren is opgelost binnen één codebase. Een AI-gebouwd product heeft vaak vier manieren om een e-mailadres te valideren, drie stijlen van foutafhandeling en twee concurrerende benaderingen voor gebruikersrechten, elk gegenereerd in een andere sessie. De data van GitClear uit 2026 laten zien dat gedupliceerde codeblokken, reeksen van vijf of meer herhaalde regels, stegen van 40,3 per miljoen gewijzigde regels in 2023 naar 73,0 in 2026 tot nu toe, een toename van 81%. Omdat veel bedrijven met dezelfde paar modellen bouwen, kan één gebrekkig patroon ook in veel codebases tegelijk opduiken; met één afgesproken patroon per probleem herstelt u die fout op één plek.
Modelveroudering
Modelveroudering speelt wanneer een product tijdens gebruik afhankelijk is van een AI-model: prompts, de verwerking van antwoorden en integraties kunnen falen of ander gedrag vertonen wanneer een modelversie wordt uitgefaseerd. Voor code die met AI is geschreven maar zonder model draait, geldt dit niet op dezelfde manier. De deprecations-pagina van OpenAI geeft algemeen beschikbare modellen minstens zes maanden opzegtermijn, gespecialiseerde varianten minstens drie maanden en previewmodellen soms maar twee weken; bij veiligheids- of compliancekwesties kan dat korter zijn. Leg de modelversie, de eigenaar, vervangingsopties en deprecation-meldingen vast, en test migraties vóór de uitfaseringsdatum.
| Type | Hoe het eruitziet | Vroeg signaal | Eerste fix |
|---|---|---|---|
| Begripsschuld | Werkende code die niemand kan uitleggen | Reviewantwoorden als “de AI heeft het geschreven” | Schriftelijke uitleg en tests per kritieke flow |
| Verborgen afhankelijkheidsschuld | Packages en diensten die niemand bewust koos | Dubbele of onbeheerde libraries in het lockbestand | Goedgekeurde lijst met dependencies; dubbelingen verwijderen |
| Patroondivergentie | Eén probleem, meerdere oplossingen | Een fix die op veel plekken moet landen | Eén afgesproken patroon per probleem; daarnaartoe refactoren |
| Modelveroudering (producten die tijdens gebruik een model aanroepen) | Prompts en integraties gebonden aan één modelversie | Geen overzicht van welke modelversie een live feature aanroept | Modelregister met eigenaar, vervangingsoptie en deprecation-meldingen |
Wat betekent AI technical debt voor uw bedrijf?
AI technical debt raakt uw bedrijf via tragere featureoplevering, meer mislukte releases en beveiligingsbevindingen die grotere deals vertragen. Het DORA-rapport 2024 vond dat 25% meer AI-gebruik samenhing met naar schatting 7,2% minder leveringsstabiliteit en 1,5% minder doorvoer. DORA (DevOps Research and Assessment) is het langlopende onderzoeksprogramma van Google Cloud naar softwareleveringsprestaties. Minder stabiliteit betekent meer releases die worden teruggedraaid of gepatcht, en elke keer gaat dat ten koste van de roadmap.
Voor een founder of COO wordt de impact op drie plekken zichtbaar. De roadmap loopt uit omdat engineers sprints aan fixes besteden in plaats van aan features. Het vertrouwen van klanten daalt wanneer releases iets breken waarop gebruikers rekenen. Salescycli worden langer wanneer een grotere klant een security-vragenlijst stuurt en het team niet kan zeggen waarvan de eigen code afhankelijk is.
Hoe schat u de AI technical debt in uw eigen product in?
Geen enkele openbare studie meet de totale technische schuld die AI-tools veroorzaken, dus schat u haar in op basis van uw eigen codebase en niet op basis van een los percentage. Beoordeel elke module op vier punten: kritikaliteit (verwerkt de module betalingen, inloggegevens, persoonsgegevens of een kernproces), testdekking van de kritieke paden, eigenaarschap (kan een benoemde persoon haar uitleggen en aanpassen) en de geschatte hersteltijd in engineeringdagen. Kritikaliteit en eigenaarschap bepalen de volgorde; de opgetelde hersteltijden geven de omvang van de schuld in engineeringdagen in plaats van als abstracte score. Een kritieke module met lage testdekking en zonder eigenaar staat bovenaan, ongeacht de hersteltijd, en de inventaris uit stap één van het raamwerk legt deze vier punten voor elke module vast.
Hoe beheert u AI technical debt?
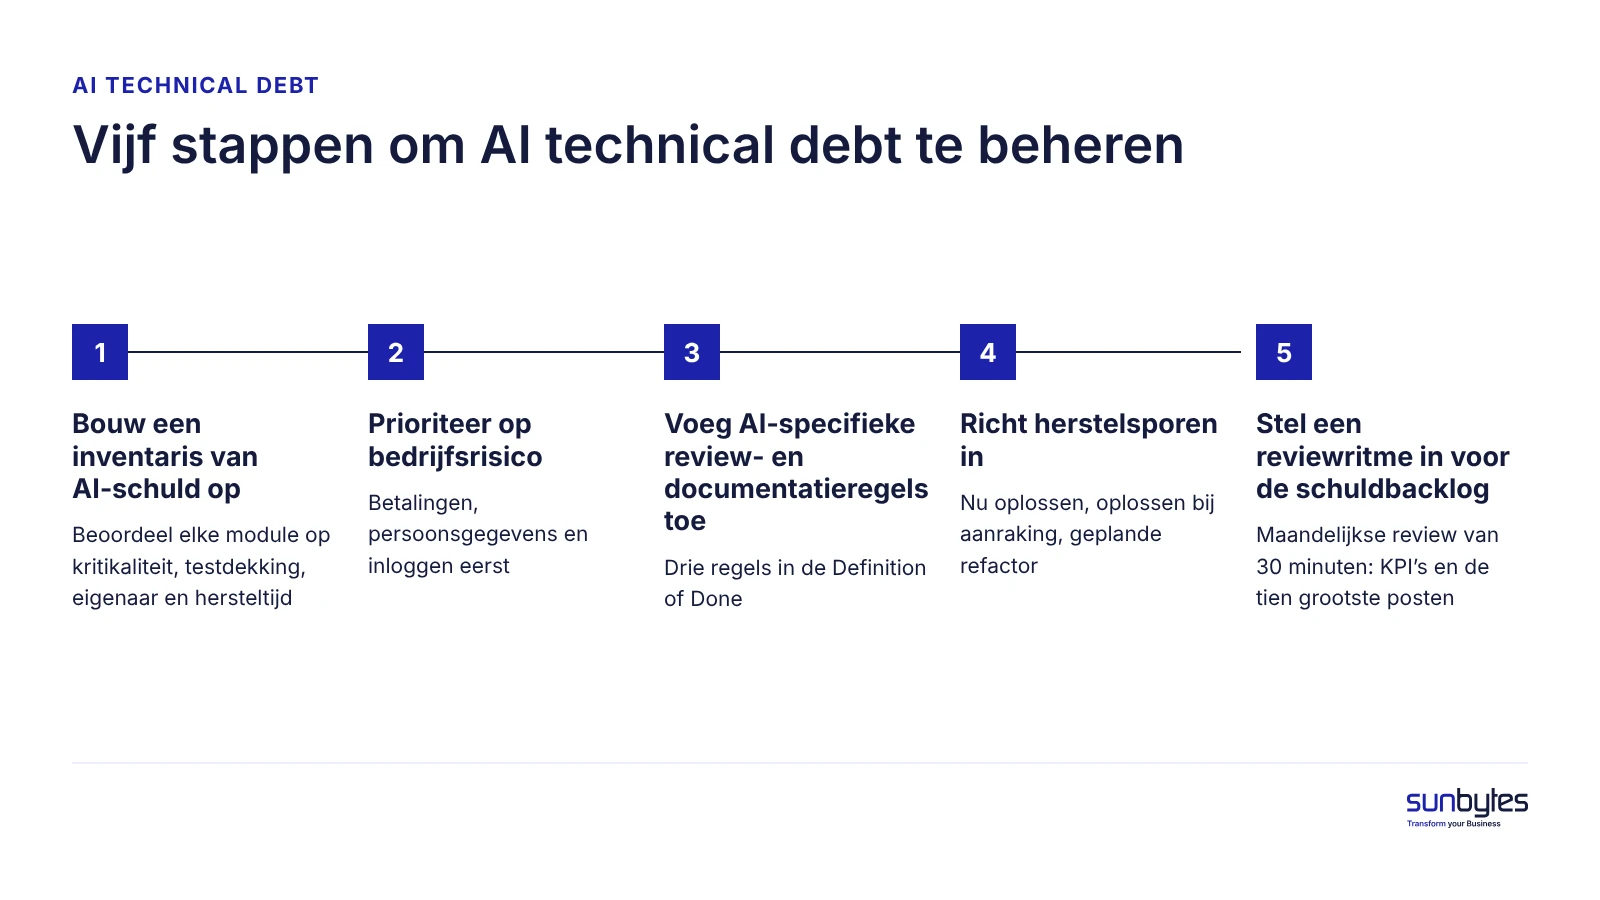
U beheert AI technical debt met een raamwerk van vijf stappen: een inventaris van AI-schuld opbouwen, prioriteren op bedrijfsrisico, AI-specifieke review- en documentatieregels toevoegen, herstelsporen inrichten en een vast reviewritme voor de schuldbacklog instellen. Voor stap één heeft u drie dingen nodig: toegang tot de volledige repository, het incidentlog van de afgelopen 90 dagen en één persoon die eigenaar is van het resultaat. Als planningsvoorbeeld voor een kleine codebase nemen stap één en twee ongeveer twee weken; grotere producten hebben meer tijd nodig, en stap drie tot en met vijf lopen daarna doorlopend.
1. Bouw een inventaris van AI-schuld op
Een inventaris van AI-schuld is een lijst van alle modules in het product, beoordeeld op de vier schuldtypen. Noteer per module de kritikaliteit, de testdekking, de eigenaar en de geschatte hersteltijd, plus de dependencies en of een AI-tool het grootste deel schreef. De inventaris is klaar wanneer elke module een beoordeling en een eigenaar heeft, en de meest gemaakte fout is alleen de modules opnemen die al incidenten veroorzaken, terwijl stille modules ook schuld dragen.
2. Prioriteer op bedrijfsrisico
Prioriteren op bedrijfsrisico betekent elke schuldpost rangschikken naar wat er misgaat als die faalt, niet naar hoe rommelig de code eruitziet. Zet modules voor betalingen, persoonsgegevens en inloggen bovenaan, gevolgd door modules die elke sprint veranderen. Artikel 21, lid 2, onder e, van de NIS2-richtlijn verplicht essentiële en belangrijke entiteiten die onder de richtlijn vallen om beveiliging te regelen bij de aanschaf, ontwikkeling en het onderhoud van hun systemen, inclusief de behandeling van kwetsbaarheden. Softwareleveranciers van die entiteiten kunnen via contracten en inkoop met dezelfde verwachtingen te maken krijgen, ook als zij zelf niet onder NIS2 vallen, en code die persoonsgegevens verwerkt valt bovendien onder artikel 32 van de AVG (GDPR).
3. Voeg AI-specifieke review- en documentatieregels toe
AI-specifieke regels voorkomen dat er nieuwe schuld bijkomt terwijl u de oude aflost. Drie regels dekken de meeste gevallen: elke AI-gegenereerde wijziging heeft een menselijke reviewer die haar kan uitleggen, nieuwe dependencies worden getoetst aan een afgesproken lijst, en elke pull request vermeldt welke AI-tool en welk model de code maakte. Neem de drie regels op in de Definition of Done van het team, zodat een wijziging die op één regel zakt teruggaat, hoe urgent de feature ook is.
Tools vangen bekende patronen op en mensen beoordelen intentie en ontwerp, zoals de vergelijking van handmatige en geautomatiseerde code review uitlegt. Voor betaal-, inlog- en privacygevoelige flows voegt een secure code review door specialisten de beveiligingslaag toe die een featurereview niet dekt.
4. Richt herstelsporen in
Herstelsporen sorteren fixes op urgentie. Een spoor “nu oplossen” is voor bevestigde hoogrisicoproblemen, gerangschikt op misbruikbaarheid, gevoeligheid van de gegevens, blootstelling en bedrijfsimpact. Een spoor “oplossen bij aanraking” schoont modules op zodra een feature ze verandert. Een spoor “geplande refactor” bevat structureel werk, vaak met het strangler fig-patroon: nieuwe code wordt rond de oude module gebouwd en vervangt die stap voor stap, zodat featurewerk nooit stilvalt voor een herschrijving.
5. Stel een reviewritme in voor de schuldbacklog
Een maandelijkse review van 30 minuten over de KPI’s en de tien grootste schuldposten houdt de backlog zichtbaar voor de meeste mkb-teams, met vóór een grote release een onafhankelijke check. Dat ritme is belangrijk omdat AI de gewoonten van een team versterkt: het DORA-rapport 2025 beschrijft de belangrijkste rol van AI in softwareontwikkeling als versterker van de bestaande sterke en zwakke punten van een organisatie.
| Kan uw team een kritieke flow niet uitleggen of geen bewijs leveren voor een security-review van een klant, begin dan met een onafhankelijke AI-built product review. U krijgt geprioriteerde bevindingen en beslist zelf of u ze intern oplost of daarvoor externe capaciteit inzet. |
Welke KPI’s zijn belangrijk voor AI technical debt?
Vijf KPI’s laten zien of AI technical debt afneemt: reviewbelasting, onderhoudsfrictie, kennisconcentratie, blootstelling via dependencies en beveiliging, en leveringsimpact. Leg voor elke KPI in de eerste 30 dagen een nulmeting vast en grijp in wanneer een KPI twee maanden achter elkaar de verkeerde kant op beweegt. Leveringsimpact gebruikt twee leveringsmetrics van DORA, change failure rate en hersteltijd, omdat het DORA-rapport 2024 meer AI-gebruik koppelde aan een lagere leveringsstabiliteit.
| KPI | Wat het meet | Waarschuwingssignaal |
|---|---|---|
| Reviewbelasting | Tijd van het openen tot het goedkeuren van een pull request, plus herwerkcommentaren per AI-wijziging | Twee maanden stijgend: reviewers begrijpen niet wat ze goedkeuren |
| Onderhoudsfrictie | Engineeringdagen per sprint voor fixes, workarounds en herwerk, op basis van het sprintbord | Een groeiend deel van elke sprint gaat naar ongepland werk |
| Kennisconcentratie | Kritieke modules die maar één persoon, of niemand, kan uitleggen | Elke kritieke module die niemand kan uitleggen |
| Blootstelling via dependencies en beveiliging | Ongepinde, onbeheerde of niet-goedgekeurde packages, plus openstaande kritieke bevindingen en het aantal dagen open | Kritieke bevindingen die langer dan één sprint openstaan |
| Leveringsimpact | DORA change failure rate en hersteltijd na een mislukte release | Een van beide stijgt terwijl het aantal releases gelijk blijft |
Waar helpt AI technische schuld te verminderen?
AI-codingtools helpen technische schuld te verminderen bij smalle, duidelijk afgebakende taken waarbij een mens elk resultaat controleert: onbekende code uitleggen, ontbrekende tests schrijven, documentatie opstellen en kleine refactors voorstellen. Het DORA-rapport 2024 koppelde 25% meer AI-gebruik aan 7,5% betere documentatie, 3,4% hogere codekwaliteit en 3,1% snellere code review. Die winst telt het zwaarst bij begripsschuld, het type dat het meest afhangt van uitleg en documentatie.
Kan AI kleine, stapsgewijze refactors voorstellen die passen bij uw roadmap voor technische schuld?
AI kan kleine, stapsgewijze refactors voorstellen die passen bij een roadmap voor technische schuld, mits elk roadmapitem specifiek is: één module, één doelpatroon en een set tests die daarna nog moeten slagen. Een prompt als “verplaats alle e-mailvalidatie in de billingmodule naar de gedeelde validator en houd alle bestaande tests groen” geeft de tool een duidelijke grens, en een mens keurt elke wijziging goed. Voor wijzigingen over meerdere modules of in het datamodel zijn AI-voorstellen minder geschikt, omdat één verkeerde stap dan meer schuld oplevert dan hij wegneemt.
Waar maakt AI technische schuld erger?
AI maakt technische schuld erger wanneer het grote hoeveelheden code schrijft die niemand regel voor regel reviewt, vooral in agent-workflows die in één run veel bestanden aanpassen. In de SusVibes-benchmark (ICML 2026) was 57% van de geteste oplossingen van SWE-Agent met Claude 4 Sonnet functioneel correct, maar voldeed slechts 11,8% aan de beveiligingscriteria van de benchmark. Dat resultaat komt uit 186 beveiligingsgevoelige taken, niet uit een willekeurige steekproef van AI-gebouwde producten. Rangschik bevindingen in een live codebase op misbruikbaarheid, gevoeligheid van de gegevens, blootstelling en bedrijfsimpact; bevestigde hoogrisicoblootstelling hoort in het spoor “nu oplossen”.
Het tweede patroon is snelheid zonder begrip. Een team dat elke maand veel AI-gebouwde features oplevert met een lichte review, bouwt tegelijk begrips-, afhankelijkheids- en patroonschuld op, en het eerste signaal is meestal een release die iets ongerelateerds breekt. Gebeurt dat twee keer in één kwartaal, pas dan de reviewregel aan vóór de volgende feature live gaat.
Hoe beheert u schuld zonder de roadmap te vertragen?
U beheert AI technical debt zonder de roadmap te vertragen door het schuldwerk in de gewone sprint op te nemen in plaats van er een apart project van te maken. Het DORA-rapport 2024 concludeerde dat AI-adoptie op zichzelf de softwarelevering niet verbetert: basisprincipes zoals kleine batches en goed testen bepalen nog steeds het resultaat. Twee werkwijzen voorkomen dat het schuldwerk in de sprint wordt weggedrukt.
Een vaste eigenaar van de schuldbacklog. Eén persoon, vaak de tech lead, houdt de inventaris actueel en brengt de drie belangrijkste schuldposten in bij elke sprintplanning. Zonder eigenaar blijven schuldposten liggen in een backlogkolom die niemand opent.
Beschermde capaciteit voor herstelwerk. Een vast deel van elke sprint wordt in de sprintplanning vastgelegd voor schuldwerk, zodat urgente features het niet ongemerkt opslokken. Begin met één engineeringdag op de tien en stel bij zodra de KPI’s een trend van twee maanden laten zien.
Hoe ziet een plan voor 30, 60 en 90 dagen eruit?
Een 30-60-90-dagenplan voor AI technical debt gaat van zichtbaarheid in de eerste maand, via controle in de tweede, naar een vaste routine op dag 90. Tabel 3 is een planningsvoorbeeld voor een team van drie tot tien engineers dat naast het gewone featurewerk aan de schuld werkt; een grotere codebase heeft langere fases nodig. De data van GitClear uit 2026 melden een stijging van 15% in two-week code churn, code die binnen twee weken na schrijven alweer wordt aangepast, dus een dalende churn binnen twee weken op dag 90 is een van de duidelijkste tekenen dat het plan werkt.
| Periode | Focus | Klaar wanneer |
|---|---|---|
| Dag 1–30 | Inventaris opbouwen, nulmetingen van de KPI’s vastleggen, niet-goedgekeurde dependencies tegenhouden | Elke module is beoordeeld en heeft een eigenaar; de drie sporen zijn afgesproken |
| Dag 31–60 | Het spoor “nu oplossen” leegmaken, de regels toevoegen aan elke pull request, de eerste geplande refactor starten | De eerste maandelijkse schuldreview heeft plaatsgevonden |
| Dag 61–90 | De KPI-trend van twee maanden lezen, voor de belangrijkste modules kiezen tussen refactoren en herbouwen, waar nodig het modelregister opzetten | De maandelijkse review loopt als routine |
Wanneer schakelt u externe hulp in voor AI technical debt?
Externe hulp voor AI technical debt is zinvol wanneer kritieke modules geen duidelijke eigenaar hebben, beveiligingsbewijs ontbreekt of hetzelfde team de eigen implementatie niet objectief kan beoordelen. Tabel 4 koppelt veelvoorkomende situaties aan een aanpak.
Artikel 21, lid 2, onder d, van de NIS2-richtlijn verplicht essentiële en belangrijke entiteiten die onder de richtlijn vallen om de beveiliging van hun toeleveringsketen te regelen, inclusief de beveiligingsaspecten van de relaties met directe leveranciers. Softwareleveranciers van die entiteiten kunnen daardoor security-vragenlijsten of contractuele eisen krijgen, ook als zij zelf niet rechtstreeks onder NIS2 vallen.
| Situatie | Aanbevolen aanpak | Waarom |
|---|---|---|
| De schuld zit in een paar modules die het team kan uitleggen, en er kunnen tests bij | Zelf oplossen | Het team heeft de context; externe hulp kost geld zonder nieuwe informatie |
| Begripsschuld zonder eigenaar in betaal-, inlog- of privacygevoelige flows | Eerst een onafhankelijke review, dan oplossen | Een externe reviewer beoordeelt de code zonder de aannames van het team |
| Open beveiligingsbevindingen of ontbrekend bewijs vóór een grote deal of een leveranciersvragenlijst | Onafhankelijke review plus secure code review | De klant vraagt om bewijs van iemand buiten het team |
| De inventaris bevat meer herstelwerk dan het team in twee kwartalen aankan | Extra engineeringcapaciteit | De roadmap stopt als dezelfde mensen beide doen |
Refactoren of herbouwen is een aparte beslissing. Herbouwen betekent een component vanaf nul vervangen in plaats van de bestaande code te verbeteren, en dat is alleen het overwegen waard wanneer de architectuur een noodzakelijke fix blokkeert, zoals toegangscontrole per klant. De signalen die tussen beide beslissen, staan in het artikel over herbouwen of refactoren. De omvang en de prijs van een onafhankelijke review hangen af van de grootte van de codebase, het aantal integraties en de hoeveelheid persoonsgegevens.
Hoe Sunbytes helpt bij AI technical debt
De inventaris uit stap één is vaak de lastigste stap om intern uit te voeren, omdat het team code moet beoordelen die het zelf heeft gebouwd.
Sunbytes begint met een onafhankelijke AI-built product review: een schriftelijke inventaris van begrips-, afhankelijkheids-, patroon- en modelschuld, gerangschikt op bedrijfsrisico en los van eventueel herstelwerk opgeleverd.
Raken de bevindingen betaal-, inlog- of privacygevoelige flows, dan voegt Cybersecurity-oplossingen de secure code review toe en het bewijs waar een security-vragenlijst van een klant om vraagt. Bevatten de herstelsporen meer werk dan uw team aankan, dan neemt een dedicated software development team de refactors over binnen uw roadmap. Doordat review en herstel gescheiden blijven, worden de bevindingen niet gekleurd door wie er betaald wordt om ze op te lossen.
Sunbytes heeft ruim 300 projecten opgeleverd voor klanten in 20 landen, binnen een ISO/IEC 27001-gecertificeerd managementsysteem voor informatiebeveiliging.
Weet u welke modules in uw product niemand kan uitleggen? Begin met een AI-built product review.