Een demo laat zien dat een workflow in een beperkt scenario werkt. Load testing levert bewijs over hoe diezelfde workflow zich gedraagt onder een vooraf bepaalde belasting, en dat bewijs hebt u als founder nodig vóór een lancering, campagne of salesoffensief. Deze gids behandelt vier beslissingen: het verkeersdoel, de flows die u test, hoe u de resultaten leest, en of u lanceert, eerst oplost of de architectuur herziet.
TL;DR
Een AI-gebouwde app is pas klaar voor lanceringsverkeer wanneer een representatieve loadtest voldoet aan drempels die vooraf zijn afgesproken: p95-responstijd, foutpercentage en capaciteit van afhankelijkheden, bij de verwachte piek plus een afgesproken marge. Geen loadtest garandeert elke situatie in de praktijk; de test laat zien hoe de app zich gedraagt onder de belasting die u hebt vastgelegd.
- Bepaal eerst het doel: zet de lancerings- of campagneprognose om in het piekaantal gelijktijdige sessies en spreek per kritieke flow een p95-drempel voor de responstijd en een maximaal foutpercentage af.
- Test de flows die omzet opleveren: registratie of inloggen, de kernactie van het product, afrekenen of betalen, en elke aanroep van een AI-model binnen een gebruikersverzoek.
- Los het eerste knelpunt op dat de resultaten tonen, draai daarna exact hetzelfde testscript opnieuw en vergelijk met de vastgelegde baseline voordat u het volgende aanpakt.
- Beslis op basis van vooraf afgesproken voorwaarden: go als elke kritieke flow zijn drempels haalt bij piek plus marge, eerst oplossen als een knelpunt geïsoleerd en te diagnosticeren is, herzien als de architectuur het halen van de drempels verhindert.
Hoeveel verkeer moet uw AI-gebouwde app aankunnen?
Uw AI-gebouwde app moet het piekaantal gelijktijdige sessies aankunnen dat volgt uit uw eigen lanceringsprognose, plus een marge die u met uw engineer afspreekt. Er geldt geen universeel getal, en de berekening begint bij een gedocumenteerde prognose, niet bij het aantal geregistreerde gebruikers.
Houd in die berekening vijf getallen uit elkaar. Geregistreerde gebruikers zijn accounts. Bezoeken zijn binnenkomsten in een periode. Actieve sessies zijn mensen die binnen een tijdvenster iets doen. Gelijktijdige gebruikers zijn sessies die op hetzelfde moment actief zijn. Verzoeken per seconde is het aantal aanroepen dat de server ontvangt. Duizend registraties betekent niet dat duizend mensen de app tegelijk gebruiken.
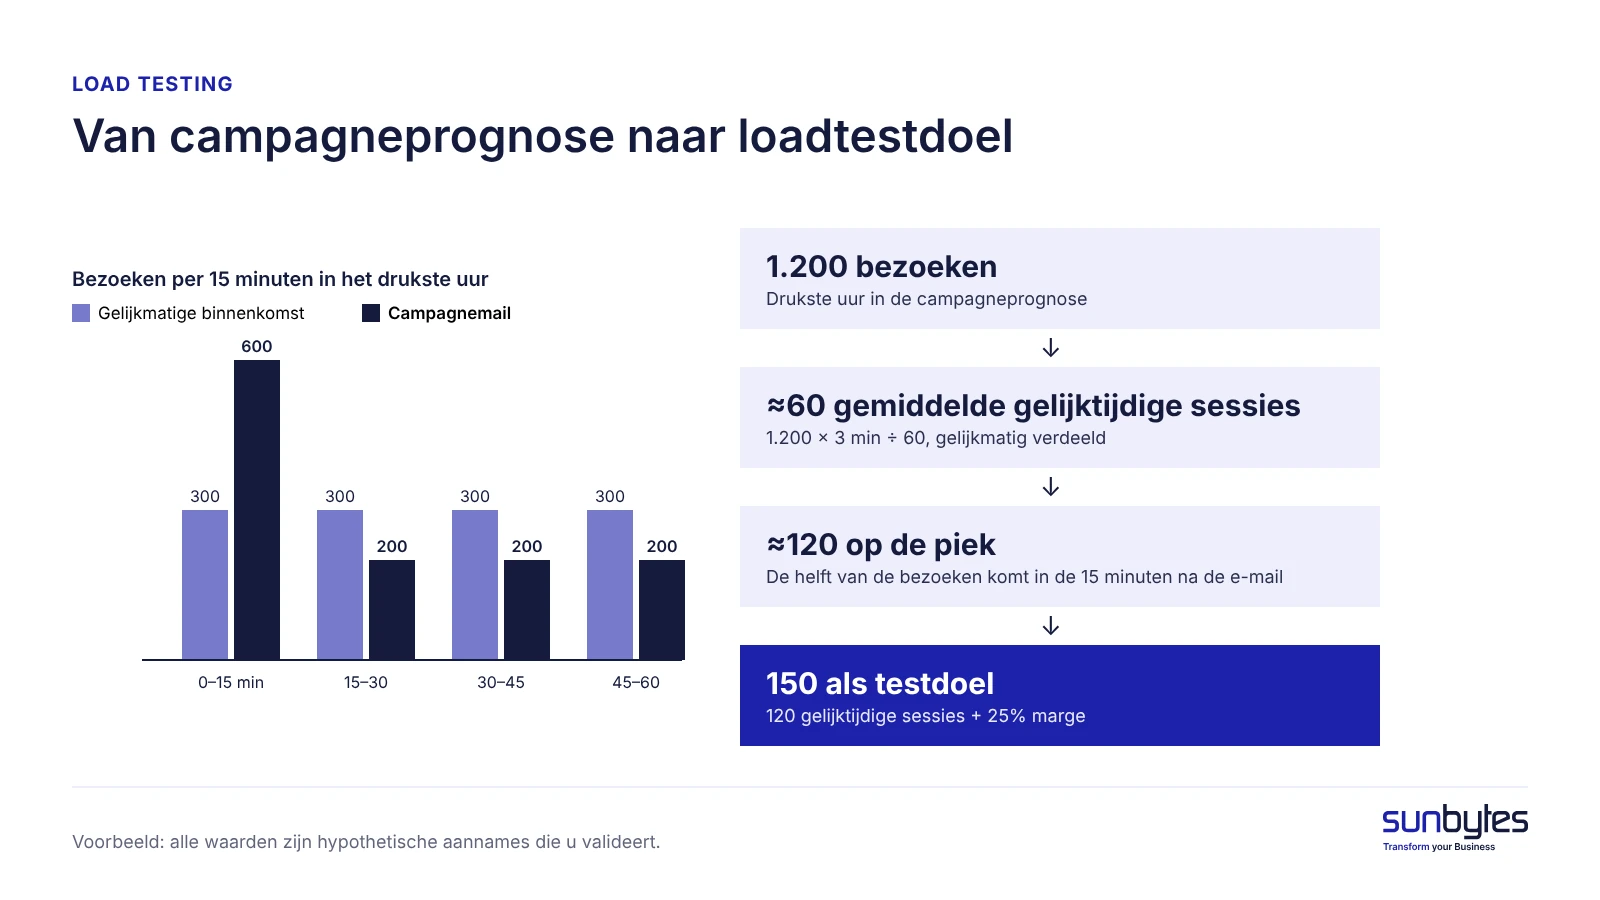
Voorbeeld: een campagneplan voorspelt 1.200 bezoeken in het drukste uur, en de analytics van de bèta tonen een gemiddelde actieve sessie van 3 minuten. Bij gelijkmatige binnenkomst geeft 1.200 × 3 ÷ 60 ongeveer 60 gemiddelde gelijktijdige sessies. Een campagnemail verdeelt bezoekers niet gelijkmatig. Neemt de engineer aan dat de helft van die bezoeken binnenkomt in de 15 minuten na verzending, dan loopt dat kwartier op een tempo van 2.400 bezoeken per uur: ongeveer 120 gelijktijdige sessies op de piek. Met 25% marge, in dit voorbeeld afgesproken, wordt het testdoel 150 gelijktijdige sessies. Elke invoerwaarde is een aanname die u valideert, geen ratio uit de branche.
Drie meetwaarden maken van dat doel een duidelijke grens tussen geslaagd en gezakt. De p95-responstijd is de tijd waarbinnen 95 van elke 100 verzoeken klaar zijn. Het foutpercentage is het aandeel verzoeken dat mislukt. Throughput is het aantal verzoeken dat de app per seconde verwerkt. Het Site Reliability Engineering-boek van Google geeft de voorkeur aan percentielen boven het rekenkundig gemiddelde, omdat een gemiddelde een lange staart van trage verzoeken kan verbergen. Een p95-drempel laat zien hoe de traagste 5% van de afrekeningen presteert onder de geteste belasting; een gemiddelde laat dat niet zien.
Kies drie tot vijf bedrijfskritieke flows: registratie of inloggen, de kernactie van het product, afrekenen of betalen, en zoeken of het laden van het dashboard. De founder bepaalt de drempels op basis van gebruikerservaring, service level objectives en commercieel risico; de engineer vertaalt ze naar een testscript. Een drempel die vóór de test is afgesproken, is meer waard dan een lang rapport erna, omdat het resultaat dan een ja of nee wordt in plaats van een discussie.
| Flow | Geschatte gelijktijdigheid | p95-drempel | Max. foutpercentage | Beperkingen van afhankelijkheden |
|---|---|---|---|---|
| Registratie / inloggen | 45 sessies | ≤ 800 ms | < 1% | E-mailprovider gestubd |
| Dashboard laden | 60 sessies | ≤ 1.500 ms | < 1% | Alleen leesacties op de database |
| Kernactie met AI-modelaanroep | 30 sessies | ≤ 8.000 ms | < 2% | Rate limits van de modelprovider op uw account |
| Afrekenen / betalen | 15 sessies | ≤ 1.000 ms | < 1% | Sandbox van de betaalprovider |
Wat vertelt load testing u?
Load testing vertelt u hoe een app zich gedraagt onder een vooraf bepaalde belasting: of hij stabiel blijft, hoe snel hij reageert en waar de capaciteit opraakt. Load testing is een vorm van prestatietesten die gelijktijdig verkeer van echte gebruikers simuleert om de stabiliteit, snelheid en capaciteit van een app te controleren. Gelijktijdige gebruikers zijn de sessies die op hetzelfde moment actief zijn; de responstijd is de tijd tussen een verzoek en een volledig antwoord.
Een demo laat zien dat een workflow één keer kan draaien. Een loadtest levert bewijs over hoe dezelfde workflow zich gedraagt wanneer de verwachte belasting tegelijk binnenkomt. Daarmee hoort de loadtest bij de controles om AI-gebouwde producten veilig live te zetten. Voor een AI-gebouwde app is een websiteloadtest die alleen pagina’s opvraagt niet genoeg: het script moet registratie, de kernactie en het afrekenen doorlopen, omdat die flows de database, de betaalprovider en de model-API raken.
Load testing valt binnen het bredere prestatietesten vóór de lancering, en de reikwijdte eindigt bij capaciteit. Een loadtest laat niet zien of gebruikersdata veilig zijn, of functies correcte resultaten geven of de code onderhoudbaar is; daarvoor zijn securitytests, functionele tests en code review nodig.
Load-, stress-, spike- en soaktests
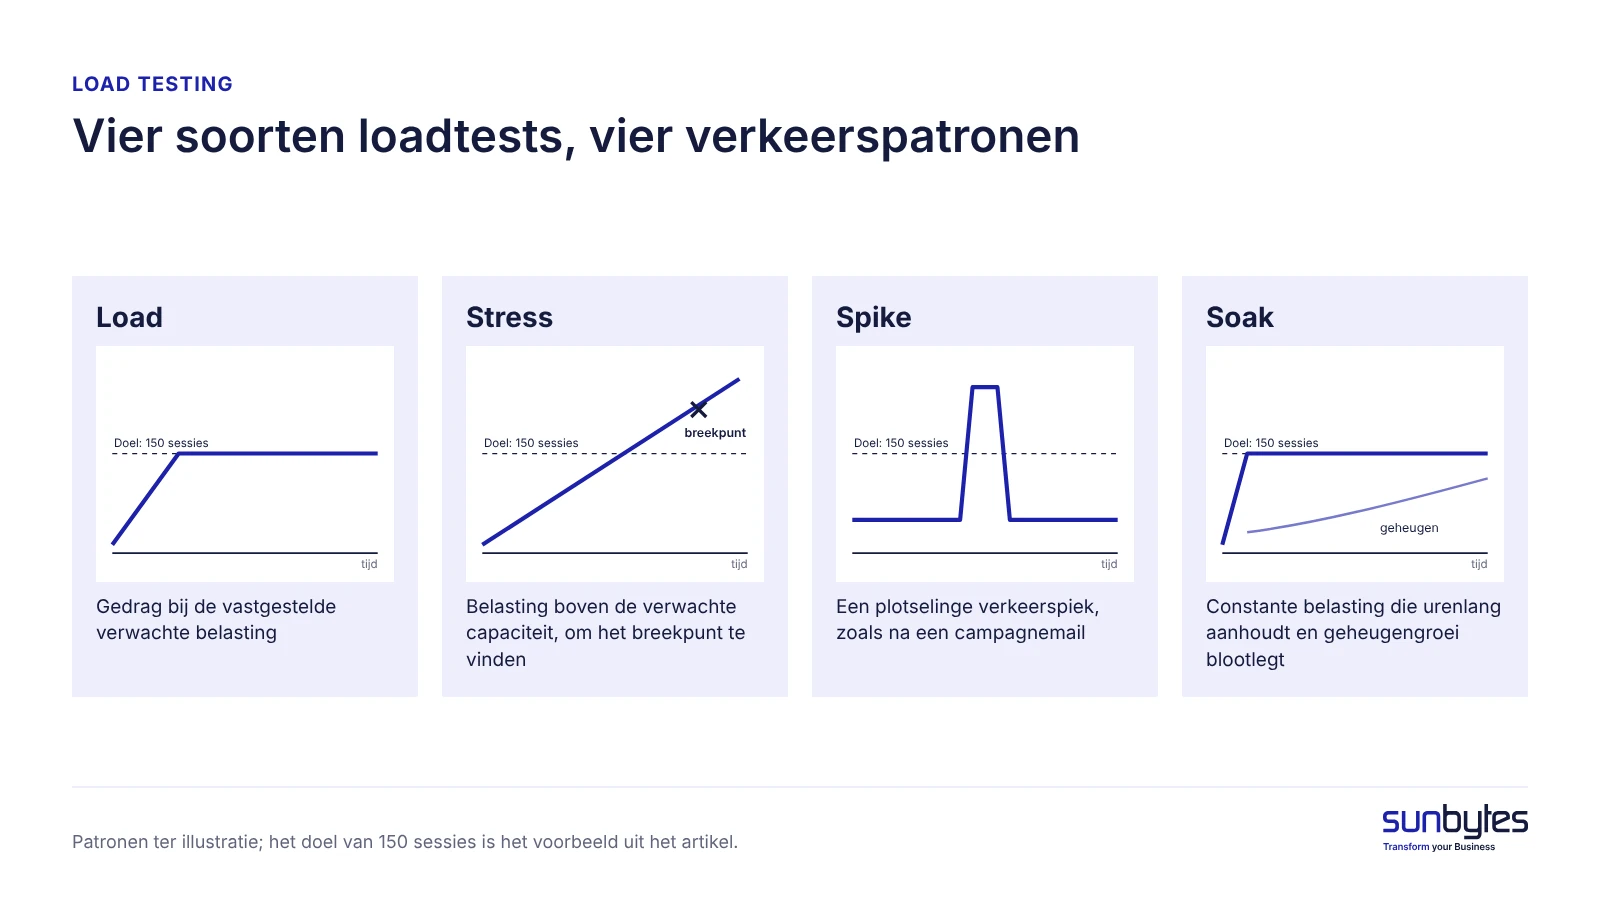
Load-, stress-, spike- en soaktests beantwoorden vier verschillende capaciteitsvragen, en u hebt ze niet alle vier nodig vóór elke lancering.
| Test | Wat de test controleert | Wanneer u hem nodig hebt |
|---|---|---|
| Load | Gedrag bij de vastgestelde verwachte belasting | Vóór elke lancering, bij verwachte piek plus marge |
| Stress | Belasting boven de verwachte capaciteit, om het breekpunt te vinden | Als u wilt weten hoe ver de app voorbij de prognose kan |
| Spike | Een plotselinge verkeerspiek, zoals na een campagnemail of persbericht | Vóór een campagne of aankondiging van de lancering |
| Soak | Een constante belasting die urenlang aanhoudt en geleidelijke groei van geheugen of wachtrijen blootlegt | Als de app achtergrondtaken of lange sessies heeft |
Begin met een load- en een spiketest als u lanceert of een campagne draait. Voeg een soaktest toe als de app achtergrondtaken, geplande AI-verwerking of lang openstaande sessies heeft, omdat trage resourcelekken pas na uren zichtbaar kunnen worden.
Zo test u uw AI-gebouwde app vóór de lancering
Test uw AI-gebouwde app in vijf stappen: spreek de belasting af, richt een stagingomgeving in die op productie lijkt, meet een baseline, voer de belasting op tot piek plus marge, en los daarna op en test opnieuw met dezelfde belasting. Werk op de dag van de release, zoals UAT, uitrol en de eerste 14 dagen monitoring, hoort bij de go-live checklist; de loadtest komt daarvoor en voedt de go-beslissing.
Een loadtest in vijf stappen
- Spreek de belasting af. Leg de kritieke flows vast, hoe gebruikers binnenkomen (gelijkmatig of in pieken), de verwachte piek, de drempels en een stopvoorwaarde, bijvoorbeeld de test stoppen zodra het foutpercentage boven 5% komt.
- Richt een stagingomgeving in die op productie lijkt. Stem databasegrootte, hostingpakket en configuratie zo goed als het budget toelaat af op productie. Stub of sandbox elke afhankelijkheid met bijwerkingen: betalingen, e-mail, sms en AI-model-API’s. Documenteer wat gesimuleerd is, want een gestubde afhankelijkheid is niet getest.
- Meet een baseline bij lage gelijktijdigheid. Draai de flows met een handvol sessies (5 in het voorbeeld) om de normale p95 en het foutpercentage vast te leggen voordat er belasting is.
- Voer op tot piek en marge. Verhoog het aantal sessies geleidelijk tot de verwachte piek, daarna tot piek plus marge (150 sessies in het voorbeeld), voer dan een spiketest uit en, als die van toepassing is, een soaktest.
- Vergelijk, los op en herhaal. Vergelijk de gemeten waarden met de drempels, onderzoek de eerste fout, los die op en draai exact dezelfde belasting opnieuw.
Gesimuleerde AI-antwoorden isoleren de prestaties van uw eigen app, maar kunnen de latency en throttling van het live model niet aantonen. Modelproviders hanteren rate limits: de rate-limitdocumentatie van OpenAI meet die bijvoorbeeld onder meer in verzoeken per minuut (RPM) en tokens per minuut (TPM), en geeft een 429-fout terug als een verzoek een limiet overschrijdt. Plan één begrensde, geautoriseerde run tegen de echte API, met lage gelijktijdigheid en een uitgavenlimiet, om de werkelijke latency te meten en te zien waar de limieten van uw account liggen.
Test na elke oplossing opnieuw met exact hetzelfde script en dezelfde belasting, en vergelijk met de vastgelegde baseline, niet met uw geheugen. Wie script en code tegelijk wijzigt, kan niet meer zien welke wijziging de cijfers veranderde. Vraag wie de test uitvoert om zes onderdelen: de ingevulde tabel met doel versus meting, de aannames over de belasting, de lijst met gestubde afhankelijkheden, de gevonden knelpunten, bewijs van de hertest na elke oplossing, en een advies: go, eerst oplossen of herzien.
Wat load testing tools wel en niet vertellen
Load testing tools meten wat er gebeurde: p95-responstijd, throughput, foutpercentage en of elke ingestelde drempel is gehaald. Sommige koppelen met profiling of tracing om te tonen waar de tijd bleef. Wat een tool zelf niet levert, is de context bij die metingen: of de belasting representatief was, hoe code en architectuur zijn opgebouwd, en welke afhankelijkheden gestubd waren.
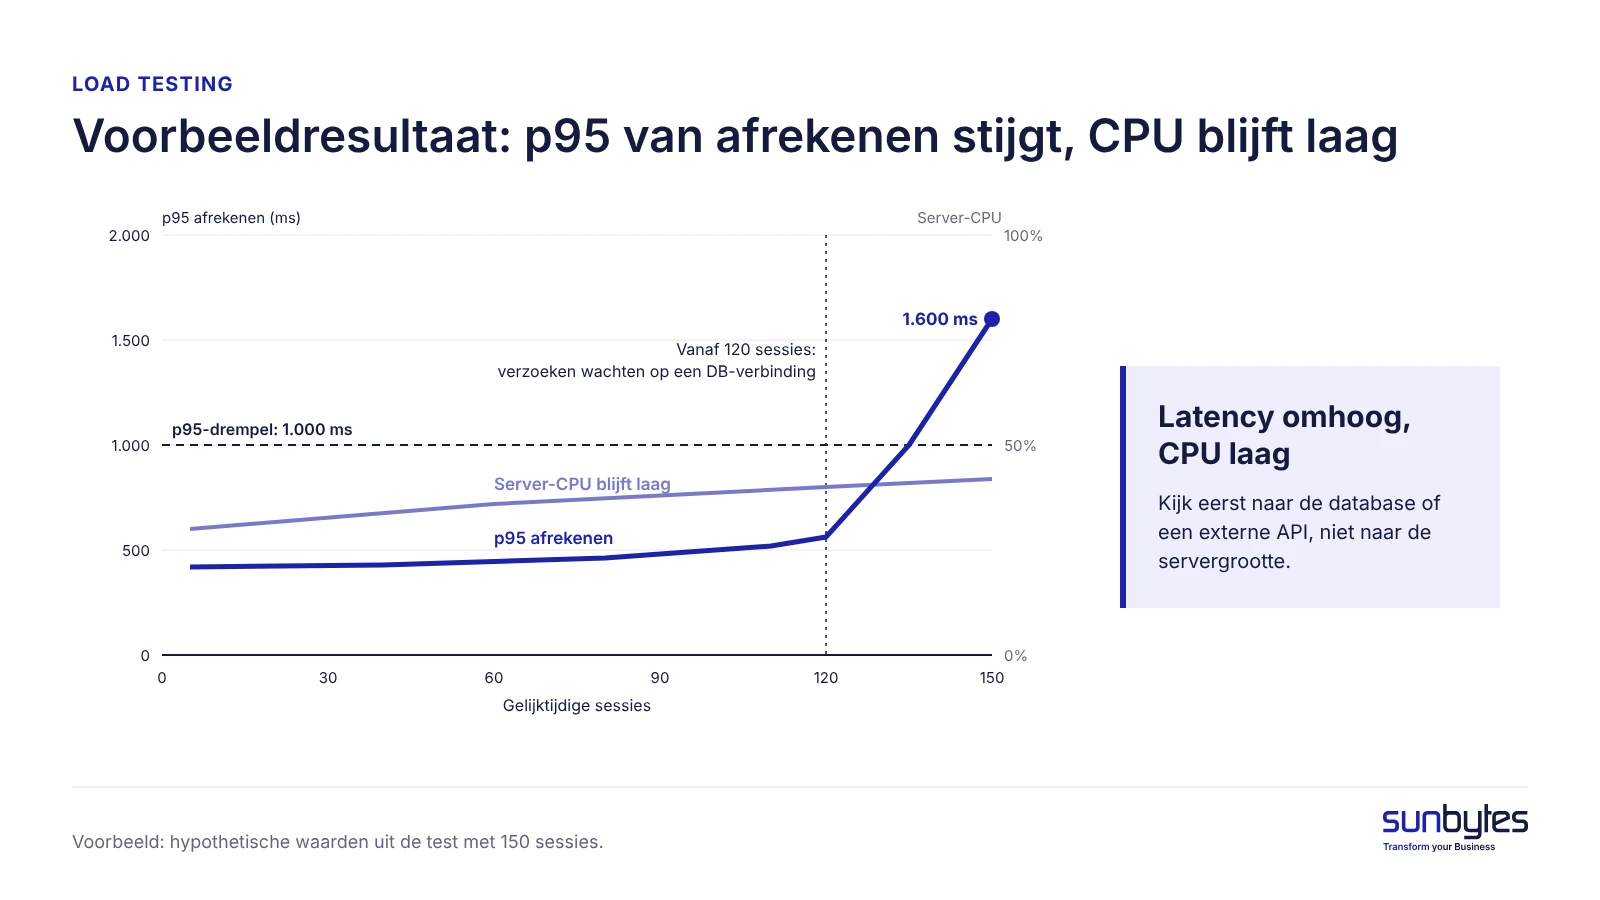
Voorbeeld: een p95-latency die vanaf 120 gelijktijdige sessies stijgt, kan samenhangen met trage databasequery’s, een verzadigde connection pool of een model-API die throttlet, en de meetwaarden alleen tonen niet altijd welke. Een technische review door een engineer voegt dat oordeel toe. Die koppelt de meting aan de code, rangschikt de mogelijke oorzaken naar zakelijke impact en bepaalt wat eerst wordt opgelost. De review vervangt de loadtest niet; ze interpreteert hem.
Loadtestresultaten interpreteren en bepalen wat u eerst oplost
Interpreteer loadtestresultaten in een vaste volgorde: vergelijk de gemeten resultaten met de afgesproken doelen, formuleer per fout een hypothese, wijs een oplossing en een eigenaar toe, en neem dan de beslissing: go, eerst oplossen of herzien. Een test kan zijn doel voor gelijktijdigheid halen en toch zakken, omdat het bereiken van de belasting iets anders is dan het halen van de prestatiedrempels.
| Meetwaarde | Afgesproken doel (voorbeeld) | Gemeten resultaat (voorbeeld) | Geslaagd / gezakt | Bewijs / toelichting |
|---|---|---|---|---|
| Bereikte gelijktijdige sessies | 150 | 150 | Geslaagd (alleen belasting) | Opbouw voltooid; op zichzelf geen geslaagde prestatietest |
| p95-responstijd afrekenen | ≤ 1.000 ms | 1.600 ms | Gezakt | Latency stijgt vanaf 120 sessies |
| Foutpercentage afrekenen | < 1% | 2,1% | Gezakt | Time-outs bij de betaalbevestiging |
| Throughput | Vastgelegd als baseline | 38 verzoeken per seconde op de piek | Niet beoordeeld | Vlakt af terwijl het aantal sessies nog stijgt |
| Druk op databaseverbindingen | Geen verzoeken die op een verbinding wachten | Verzoeken wachten op een verbinding vanaf 120 sessies | Gezakt | Connection pool uitgeput tijdens de spike |
| Throttling van de AI-API | Geen 429-antwoorden in de begrensde run tegen de echte API | 429-antwoorden bij 30 sessies | Gezakt | Rate limit van het account bereikt |
Leg de omstandigheden vast bij de resultaten (locatie van de loadgenerator, realisme van de testdata, gestubde afhankelijkheden, duur en stopvoorwaarde), anders is de volgende run niet te vergelijken met deze.
Als een app alleen is gevalideerd met licht verkeer of kleine datavolumes, kan stijgende gelijktijdigheid trage query’s, API-throttling of oplopende wachtrijen blootleggen, ongeacht of een mens of een AI-tool de code schreef. Vijf patronen zijn het eerst het controleren waard, elk met het zakelijke gevolg voorop:
- Pagina’s worden trager naarmate de data groeit: query’s die per item in een lijst opnieuw draaien (het N+1 query-patroon) en ontbrekende indexen, de opzoekstructuren waarmee een database rijen vindt zonder een hele tabel te doorzoeken.
- Elke bezoeker zet hetzelfde dure werk in gang: geen caching, die een berekend resultaat bewaart voor hergebruik.
- Eén zware gebruiker of bot kan de capaciteit opmaken: geen rate limiting, die beperkt hoeveel verzoeken één client per periode mag sturen.
- Elke extra gebruiker wordt een extra betaalde aanroep: een AI-model-API die binnen het verzoek van de gebruiker wordt aangeroepen, waardoor de app de latency en rate limits van de provider overneemt.
- Elke pagina laadt traag op mobiel: zware front-end bundles die grote JavaScript-bestanden naar elk apparaat sturen.
Gehoste databases zoals Supabase hebben verbindingslimieten die een verkeerspiek kan bereiken. Met connection pooling delen veel verzoeken een kleine set open databaseverbindingen, en de verbindingsdocumentatie van Supabase raadt de pooler in transactiemodus aan voor serverless- en edgefuncties, die veel kortstondige verbindingen openen. Query- en indexoplossingen worden uitgebreid behandeld onder databaseprestaties. Eén signaal verkleint de zoektocht: stijgt de responstijd sterk terwijl de CPU van de server laag blijft, kijk dan eerst naar de database of een externe API en niet naar de servergrootte.
| Symptoom | Waarschijnlijke oorzaak | Type oplossing | Eigenaar van de oplossing |
|---|---|---|---|
| p95 stijgt naarmate het datavolume groeit | N+1-query’s of ontbrekende indexen | Query’s herschrijven, indexen toevoegen | Backend-engineer |
| Verzoeken wachten op een databaseverbinding tijdens pieken | Connection pool uitgeput of te veel directe verbindingen | Connection pooling en poolgrootte | Backend- of DevOps-engineer |
| 429-fouten of lange wachttijden bij AI-functies | Rate limit van de modelprovider bereikt | Aanroepen in een wachtrij of batch zetten, herhaalde prompts cachen, hogere limiet aanvragen | Backend-engineer met de accounteigenaar |
| Geheugen groeit tijdens een soaktest tot de app herstart | Geheugenlek of onbegrensde wachtrij in het geheugen | Lek dichten, wachtrij begrenzen | Backend-engineer |
| CPU bijna 100% terwijl de responstijd stijgt | Dure berekening bij elk verzoek | Resultaten cachen en code optimaliseren, daarna hosting dimensioneren | Backend- of DevOps-engineer |
De blootstelling aan AI-kosten volgt dezelfde belasting. Geschatte AI-API-uitgaven zijn het aantal modelaanroepen vermenigvuldigd met de gemiddelde kosten per aanroep, gecorrigeerd voor input- en outputtokens, herhaalpogingen en caching. Voorbeeld: als 20% van de 1.200 campagnebezoeken de kernactie uitvoert en elke uitvoering 4 modelaanroepen doet, levert het drukste uur 960 aanroepen op; met 5% herhaalpogingen na throttling ongeveer 1.008. Vermenigvuldig dat met de kosten per aanroep in het dashboard van uw provider voordat de campagne start.
Een groter hostingpakket kan de maandrekening verhogen zonder inefficiënte query’s, throttling bij de AI-provider of ontbrekende caching op te lossen, omdat geen van die knelpunten in de servergrootte zit; stel eerst de diagnose.
| Beslissing | Voorwaarden, vóór de test afgesproken | Volgende stap |
|---|---|---|
| Go | Elke kritieke flow haalt zijn p95- en foutpercentagedrempels bij verwachte piek plus marge, zonder onaanvaardbare fouten in afhankelijkheden | Ga verder met de go-live checklist |
| Eerst oplossen | Fouten zijn geïsoleerd en te diagnosticeren, zoals één trage query of een poolinstelling | Oplossen, exact dezelfde test opnieuw draaien, pas na een geslaagde test lanceren |
| Herzien | De architectuur verhindert het halen van de drempels, of betrouwbaar herstel is niet haalbaar | Herzie de architectuur vóór de lancering |
In het voorbeeld zakt het afrekenen op p95 en foutpercentage, raakt de connection pool verzadigd en throttlet de AI-API bij 30 sessies. Connection pooling en een wachtrij voor modelaanroepen zijn geïsoleerde oplossingen, dus de beslissing is eerst oplossen, gevolgd door een hertest bij 150 sessies. Een geslaagde test is bewijs voor de geteste belasting, geen certificering voor elke situatie in productie. Lanceer geen campagne voordat de spiketest bij het doel slaagt.
Kan de oorzaak van een fout niet uit de testresultaten worden vastgesteld, dan kan een onafhankelijke review van uw AI-gebouwde product helpen om de code en architectuur achter het knelpunt te beoordelen.
Uw EU-dataverantwoordelijkheden bij load testing
Valt de verwerking door uw app binnen het toepassingsgebied van de AVG (GDPR), dan vereist artikel 32 van de AVG beveiligingsmaatregelen die passen bij de risico’s. Lid 1, onder b, gaat over de blijvende beschikbaarheid en veerkracht van verwerkingssystemen en -diensten, naast vertrouwelijkheid en integriteit. Lid 1, onder d, vraagt om het regelmatig testen en evalueren van beveiligingsmaatregelen. Geen van beide bepalingen schrijft specifiek load testing voor. Waar dat past bij de risico’s, kunnen loadtestresultaten bewijs ondersteunen over beschikbaarheid en veerkracht onder de geteste omstandigheden; op zichzelf tonen ze geen naleving van de AVG aan.
Gebruik in staging standaard synthetische of passend gede-identificeerde data. Dit is een aanbevolen testbeleid, gebaseerd op het beginsel van minimale gegevensverwerking in artikel 5, lid 1, onder c, dat persoonsgegevens beperkt tot wat noodzakelijk is voor het doel; live klantdata naar staging kopiëren vraagt om een eigen rechtsgrond, waarborgen en risicobeoordeling. Een loadtest heeft een realistisch datavolume nodig, geen echte identiteiten.
Levert u software of diensten aan organisaties die onder de NIS2-richtlijn vallen, dan kunnen die klanten bij hun leveranciersbeoordeling om bewijs van veerkracht vragen. Artikel 21, lid 2, onder c, gaat over bedrijfscontinuïteit, herstel na een calamiteit en crisisbeheer; artikel 21, lid 2, onder d, over de beveiliging van de toeleveringsketen, inclusief directe leveranciers en dienstverleners. Een relevant loadtestrapport kan die beoordeling ondersteunen, maar artikel 21 schrijft niet voor elke leverancier een specifieke loadtest of een specifiek rapport voor.
Bewaar de doelentabel, de testdatum, de testomstandigheden en de resultaten als verslag van één pagina voor klanten en auditors.
Hoe Sunbytes prestatietests vóór de lancering beoordeelt
Een loadtest laat zien waar een AI-gebouwde app vertraagt of faalt onder een vooraf bepaalde belasting; hij verklaart niet waarom de code, de architectuur of de afhankelijkheden zich zo gedragen. Sunbytes behandelt meten en beoordelen daarom als aparte activiteiten. De AI-Built Product Review is een onafhankelijke technische review van een afgesproken scope op vijf gebieden: beveiliging en data, code en architectuur, betrouwbaarheid en kritieke processen, livegang en beheer, en onderhoudbaarheid en code-eigenaarschap. Omdat beveiliging en code in dezelfde review zitten, wordt een trage afrekenflow bekeken samen met de foutafhandeling, de afhankelijkheden en de deployment-inrichting erachter.
De review levert heldere bevindingen met het bewijs erachter, een geprioriteerd actieplan dat scheidt wat nu moet en wat kan wachten, en een technische overdracht waarmee uw team aan de slag kan. Het uitvoeren van een loadtest, capaciteitscertificering en gegarandeerde lanceringscapaciteit zijn standaard niet inbegrepen. Hebt u een loadtest of de implementatie van oplossingen nodig, dan kan het product engineering-team van Sunbytes dat werk apart afbakenen.
Het werk valt onder het ISO 27001-gecertificeerde managementsysteem voor informatiebeveiliging van Sunbytes, met delivery onder Nederlandse leiding, 15+ jaar ervaring in softwareontwikkeling en 300+ opgeleverde projecten.
Plant u een lancering of campagne voor een AI-gebouwde app? Neem contact met ons op over een AI-Built Product Review; elk product is anders, dus de scope spreken we per geval af.