Code die met AI is geschreven, kan vandaag werken en toch lastig te onderhouden, te testen of veilig aan te passen zijn. Gedupliceerde logica, ontbrekende tests en onduidelijke dependencies hoeven bij de eerste release geen probleem te zijn, maar ze kunnen latere wijzigingen moeilijker maken en de kans op regressies vergroten.
AI code quality meten betekent verder kijken dan de vraag of de code draait. Dit artikel behandelt zeven praktische indicatoren, hoe u ze interpreteert, welk bewijs in welke productfase telt en waarom geautomatiseerde scores menselijk oordeel niet vervangen.
TL;DR
AI-codekwaliteit is de kwaliteit van code die met een AI-codingtool is geschreven: werkt de code correct, en kunnen mensen haar later begrijpen, testen en veilig aanpassen? Een AI-tool kan helpen zijn eigen output te reviewen, maar die zelfbeoordeling vervangt geen deterministische controles, uitkomstdata en menselijke review.
- Zeven indicatoren: gedupliceerde bedrijfslogica, complexiteit in impactvolle bestanden, test coverage op kritiek gedrag, risico in dependencies, bevindingen uit static analysis, change failure rate en code churn op korte termijn, gelezen als trend met een datum.
- Zo leest u ze: elke indicator wijst een gebied aan dat onderzoek verdient; geen van de zeven bewijst op zichzelf dat de code goed of slecht is.
- Bewijs per fase: voor een prototype werkende kritieke flows; zodra gebruikers ervan afhangen risicogerichte tests en geen bekende misbruikbare kwetsbaarheden; een vastgelegde onderhoudbaarheidscheck voordat anderen de code aanpassen.
- Grenzen: geautomatiseerde scores laten niet zien of toegangsbeheer klopt, of persoonsgegevens rechtmatig worden verwerkt en of de architectuur de komende 12 maanden van het product aankan.
Wat betekent AI-codekwaliteit?
AI-codekwaliteit is de kwaliteit van code die met een AI-codingtool is gemaakt, beoordeeld met dezelfde maatstaf als andere software. Doet de code wat het product nodig heeft, correct en veilig? En kunnen anderen dan de tool die haar schreef de code begrijpen, testen en wijzigen zonder te breken wat al werkt? Werkende functionaliteit en onderhoudbare code zijn twee verschillende eigenschappen, en een AI-gebouwd product heeft beide nodig.
Het internationale kwaliteitsmodel voor softwareproducten, ISO/IEC 25010:2023, geeft die eigenschappen een naam. De norm noemt negen kenmerken: functional suitability, performance efficiency, compatibility, interaction capability, reliability, security, maintainability, flexibility en safety. Ontwikkelen met AI zet vooral onderhoudbaarheid (maintainability) onder druk. De norm deelt die op in vijf subkenmerken: modulariteit (modularity), herbruikbaarheid (reusability), analyseerbaarheid (analysability), aanpasbaarheid (modifiability) en testbaarheid (testability). De metingen in dit artikel richten zich op onderhoudbaarheid en de betrouwbaarheid van wijzigingen. Over de andere kenmerken zeggen ze weinig; die vragen hun eigen controles.
In een AI-gebouwd product weegt onderhoudbaarheid zwaarder, niet lichter. Voert een AI-codingtool ook de volgende wijziging uit, dan leest die tool de bestaande code als context. Gedupliceerde logica en een inconsistente structuur worden zo patronen die de tool kan herhalen. De gids voor founders over AI-gebouwde producten veilig live zetten beschrijft dit risico op productniveau; kwaliteitsmeting maakt het zichtbaar in de code.
7 indicatoren om AI-codekwaliteit te beoordelen
Zeven codekwaliteitsmetrics geven een founder een praktisch beeld van code die een AI-tool schreef, mits u ze leest als indicator en niet als oordeel: gedupliceerde bedrijfslogica, complexiteit in impactvolle bestanden, test coverage op kritiek gedrag, risico in dependencies, bevindingen uit static analysis, change failure rate en code churn op korte termijn. Vijf ervan beschrijven de code zelf. Change failure rate is een operationeel uitkomstsignaal en churn laat zien hoe de code door de tijd verandert. Elke indicator vertelt u waar u moet kijken, niet wat het oordeel is.
| Indicator | Wat hij meet | Hoe u hem leest | Databron |
|---|---|---|---|
| 1. Gedupliceerde bedrijfslogica | Regels zoals prijzen, rechten of validatie die op meer dan één plek zijn geïmplementeerd | Reden tot zorg als één bedrijfswijziging op meerdere plekken moet gebeuren. Niet elke kopie is een probleem; alle duplicatie verwijderen kan de koppeling tussen onderdelen vergroten | Static analysis, plus een developer die nagaat wat de duplicaten bevatten |
| 2. Complexiteit in impactvolle bestanden | Hoe moeilijk de bestanden te volgen zijn die vaak wijzigen of waar kritieke flows van afhangen. Cyclomatische complexiteit telt de paden door een functie; cognitieve complexiteit schat hoe moeilijk code te lezen is | Vaak wijzigen kan ook betekenen dat het product volgens plan groeit. Lees complexiteit samen met de defecthistorie en met hoe ver een wijziging in dat bestand doorwerkt | Static analysis, versiebeheer en defecthistorie |
| 3. Test coverage op kritiek gedrag | Of geautomatiseerde tests het belangrijkste gedrag uitvoeren én controleren, zoals inloggen, betalen en toegang tot persoonsgegevens | Coverage laat zien welke code tijdens tests draait, niet of de tests een fout zouden opmerken. Zoek naar risicogerichte tests met asserties op het verwachte resultaat | Testrunner in de CI-pipeline |
| 4. Risico in dependencies | Externe packages met bekende misbruikbare kwetsbaarheden, packages zonder ondersteuning en reguliere updates | Houd de drie gescheiden: een verouderd package is niet automatisch onveilig; een bekende misbruikbare kwetsbaarheid in een gebruikt package vraagt om een eigenaar en een plan | Dependencyscanner en kwetsbaarheidsadviezen |
| 5. Bevindingen uit static analysis | Typefouten, linterwaarschuwingen en andere problemen die een tool vindt zonder de code uit te voeren | Sorteer op ernst en betrouwbaarheid, en tel uitgeschakelde regels mee. Een stijgend aantal uitzonderingen kan problemen verbergen die de totalen niet meer tonen | Typechecker en linter in de CI-pipeline |
| 6. Change failure rate | Het aandeel deployments dat direct na de release ingrijpen vraagt, zoals een hotfix of rollback | Een operationeel uitkomstsignaal, geen directe meting van de broncode. Stijgt het na een periode van snel featurewerk met AI, kijk dan naar tests en review | Deployment- en incidentregistratie |
| 7. Code churn op korte termijn | Het aandeel nieuwe code dat binnen enkele weken na toevoegen wordt herschreven of verwijderd | Churn kan stijgen door experimenten of actieve refactoring. Het telt pas als het samengaat met steeds terugkerend herstelwerk op hetzelfde gebied of met defecten | Versiebeheerhistorie |
Change failure rate komt uit de softwareleveringsmetrics van DORA. DORA omschrijft deze metric (als “change fail rate”) als het aandeel deployments dat direct ingrijpen vereist, zoals een hotfix of rollback. De metric meet wat er gebeurt nadat een wijziging live staat. Daarmee vult hij de indicatoren op codeniveau aan in plaats van ze te vervangen, en hij is iets anders dan code churn op korte termijn, die kijkt naar code die kort na het schrijven opnieuw wordt geschreven.
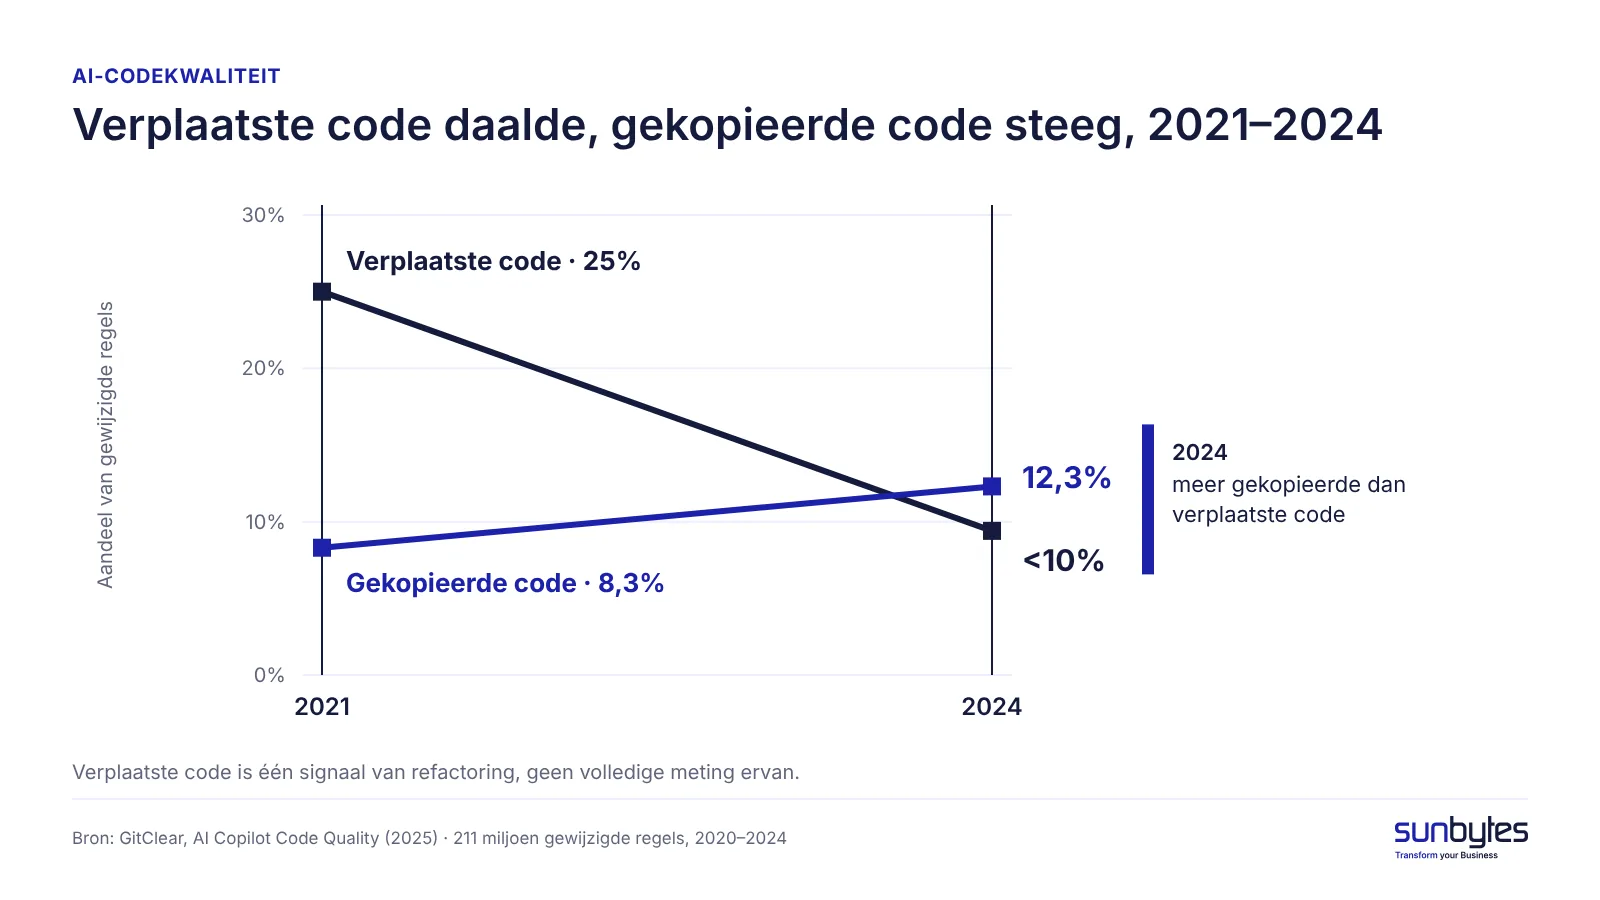
Waarom duplicatie en churn in de baseline horen, blijkt uit onderzoek naar grote codebases. GitClear analyseerde in 2025 211 miljoen gewijzigde regels uit de periode 2020–2024. Het aandeel verplaatste code daalde van 25% van de gewijzigde regels in 2021 naar minder dan 10% in 2024; gekopieerde regels stegen in dezelfde periode van 8,3% naar 12,3%. Verplaatste code is één signaal van refactoring, geen volledige meting ervan: niet elke refactoring levert verplaatste regels op. Het vervolgonderzoek The Maintainability Gap: AI Code Quality in 2026, gebaseerd op 623 miljoen wijzigingen uit 2023–2026, ziet dezelfde richting. Beide onderzoeken plaatsen de verschuiving in de periode waarin AI-codingassistenten zich verspreidden; geen van beide bewijst dat die tools de enige oorzaak zijn. Voor een founder is de praktische conclusie dat duplicatie en churn een plek in de baseline verdienen.
Leg een baseline met datum vast en werk die bij op momenten die ertoe doen in de ontwikkelcyclus, zoals grote releases, ingrijpende architectuurwijzigingen of vaste engineeringreviews. Wordt het product actief doorontwikkeld, verzamel de metingen dan automatisch en continu, en bespreek de trend in een afgesproken ritme. Wil het team cijfermatige doelen, baseer die dan op uw eigen baseline en niet op de cijfers van een ander bedrijf.
Wijzen de indicatoren steeds naar dezelfde gebieden, dan laten ze ook zien waar technische schuld door AI zich opbouwt. De indicatoren vertellen waar u moet kijken; een AI code review vertelt wat er mis is in de bestanden waar ze naar wijzen.
Zeven cijfers laten zien waar de code mogelijk zwak is, maar niet waarom of wat eerst moet. Een review van uw AI-gebouwde product leest de code achter de cijfers en legt de bevindingen in begrijpelijke taal uit, met een geprioriteerd actieplan. Geen scanner-export.
Zo controleert u de onderhoudbaarheid van code die een AI-tool schreef
U beoordeelt de onderhoudbaarheid van code het best door na te gaan hoe gemakkelijk developers de code kunnen begrijpen, wijzigen en testen zonder onverwachte problemen te veroorzaken. Uw eigen engineeringteam kan deze beoordeling uitvoeren. Een developer die de codebase niet kent, voegt vooral vóór een overdracht een extra perspectief toe, maar is niet bij elke onderhoudbaarheidscheck nodig.
Begin bij een impactvol deel van de codebase, zoals een module die vaak wijzigt of een kritieke bedrijfsflow, en volg dan vijf stappen:
- Bepaal wat u reviewt. Kies met codekwaliteitsindicatoren, wijzigingshistorie en gemelde defecten de gebieden waar onderhoudbaarheid het zwaarst weegt.
- Toets of de code te begrijpen is. Laat een engineer de relevante bedrijfsregels, dependencies en datastromen aanwijzen. Noteer ongedocumenteerde aannames, gedupliceerde logica en onduidelijke verbanden tussen componenten.
- Voer een representatieve wijziging uit. Maak een kleine, realistische aanpassing op een aparte branch. Noteer hoeveel componenten de wijziging raakt en of er onverwachte afhankelijkheden opduiken.
- Controleer het resultaat. Draai de relevante geautomatiseerde tests, ga na of ze het bedoelde gedrag echt valideren en laat een tweede engineer de wijziging reviewen. Noteer regressies en alles wat het controleren van de wijziging lastig maakte.
- Prioriteer de bevindingen. Pak eerst de problemen aan die kritieke wijzigingen onveilig maken of de oplevering steeds vertragen. Kleinere verbeteringen kunt u inplannen naast de featureontwikkeling.
Wie dat werk na de lancering oppakt, leest u in onderhoud van een AI-gebouwde app.
Wat is goed genoeg voor uw product?
Goed genoeg hangt af van wat de code moet dragen, niet alleen van de omzet. Het bewijs dat telt, groeit mee met het risico: wie van het product afhangt, welke data het verwerkt en wie de code nog meer gaat aanpassen. Tabel 2 is een werkrichtlijn uit reviews van AI-gebouwde producten, geen branchebenchmark, en bevat daarom geen percentages.
| Situatie | Bewijs dat telt | Wat kan wachten |
|---|---|---|
| Prototype: alleen de oorspronkelijke bouwer wijzigt de code, geen echte gebruikersdata | Kritieke flows werken van begin tot eind; geen secrets of API-sleutels in de code | Kwaliteitsdoelen; meten van duplicatie en complexiteit |
| Echte gebruikers, betalingen of persoonsgegevens hangen van het product af | Risicogerichte tests met asserties op inloggen, betalen en toegang tot persoonsgegevens; geen bekende misbruikbare kwetsbaarheden in gebruikte dependencies; change failure rate wordt bijgehouden | Cijfermatige doelen voor duplicatie en complexiteit |
| Anderen gaan de code aanpassen: nieuwe medewerkers, een bureau, een overdracht of een externe review | Een baseline met datum van de zeven indicatoren; een vastgelegde onderhoudbaarheidscheck op impactvolle gebieden; gedupliceerde bedrijfslogica en complexiteit beoordeeld in impactvolle bestanden | Verbeteringen in code die zelden wijzigt en waar geen kritieke flow van afhangt |
Begin met meten zodra iemand anders dan de oorspronkelijke bouwer de code gaat aanpassen, of zodra gebruikers ervan afhangen, wat het eerst komt. Releases van daarvoor hebben geen baseline om mee te vergelijken.
Wat codekwaliteitsmetrics u niet vertellen
Codekwaliteitsmetrics laten zien waar code mogelijk zwak is, maar niet of het product veilig het juiste doet. Voor AI-gebouwde producten zijn er vier grenzen.
Scores kunnen schijnzekerheid geven. Vraagt u een AI-codingtool een cijfer omhoog te krijgen, dan kan de tool dat doen zonder de code te verbeteren. Tests die code uitvoeren maar niets controleren, verhogen de coverage, en het verzoek om “de linter te fixen” kan een regel uitschakelen terwijl de oorzaak blijft. Hoe u nagaat of tests falen als de code kapot is, leest u in AI-gebouwde applicaties testen.
Scores beoordelen geen correctheid. Een bestand met lage complexiteit en hoge coverage kan nog steeds de ene klant de gegevens van een andere klant laten zien, omdat een test bijvoorbeeld alleen controleert of een pagina laadt en niet wie die mag zien.
Scores beoordelen geen beveiliging of compliance. Of toegangsbeheer goed is ontworpen en of persoonsgegevens rechtmatig worden verwerkt onder de AVG (GDPR), vraagt om een security- en privacyreview.
Scores beoordelen niet of de architectuur past. Of het ontwerp de features, gebruikers en integraties van de komende 12 maanden aankan, is een beslissing voor mensen die weten wat het product straks moet doen.
Zo legt u codekwaliteit vast voor een review
Een vastlegging van codekwaliteit voor een klant, investeerder of nieuwe engineeringpartner past op één pagina met een datum: de zeven indicatoren met hun trend, test coverage op kritiek gedrag, het actuele risico in dependencies en wie de code beheert en kan aanpassen. Gebruik daarbij de termen van ISO/IEC 25010, zoals onderhoudbaarheid of betrouwbaarheid, zodat reviewers het op dezelfde manier lezen. Waar investeerders naast codekwaliteit naar kijken, leest u in technical due diligence voor AI-gebouwde producten.
Voor sommige producten geeft de Europese Cyber Resilience Act (Cyberweerbaarheidsverordening), Verordening (EU) 2024/2847, een extra reden om zo’n vastlegging bij te houden. De verordening geldt voor producten met digitale elementen, inclusief gegevensverwerking op afstand die een product nodig heeft om te functioneren; een webapplicatie die puur als dienst wordt geleverd, valt er mogelijk buiten. De meldplichten gelden vanaf 11 september 2026 en de meeste andere verplichtingen vanaf 11 december 2027 (artikel 71). Ga na of de verordening op uw product van toepassing is.
Zo beoordeelt Sunbytes AI-codekwaliteit
Codekwaliteitsmetrics wijzen gebieden aan die onderzoek verdienen, maar verklaren niet elk risico en bepalen niet welke wijzigingen voorrang krijgen. De AI-Built Product Review van Sunbytes combineert software-engineering- en securitykennis om de afgesproken technische scope te onderzoeken, waaronder codestructuur, dependencies, onderhoudbaarheid, kritieke workflows en securityrisico’s.
In plaats van te varen op een scannerscore, onderzoeken engineers het bewijs achter de bevindingen en wat de problemen voor het product betekenen. U ontvangt heldere bevindingen, een geprioriteerd actieplan en een technische overdracht waarmee uw team verbeteringen kan plannen. Uw team kan de problemen zelf oplossen, of Sunbytes stelt apart een scope voor het herstelwerk op.
Sunbytes heeft meer dan 15 jaar ervaring in softwarelevering, verspreid over meer dan 300 projecten, met aansturing vanuit Nederland en een ISO 27001-gecertificeerd managementsysteem voor informatiebeveiliging.
Wilt u weten of uw AI-gebouwde codebase veilig aan te passen is? Neem contact met ons op om de kwaliteit en technische risico’s te laten beoordelen.